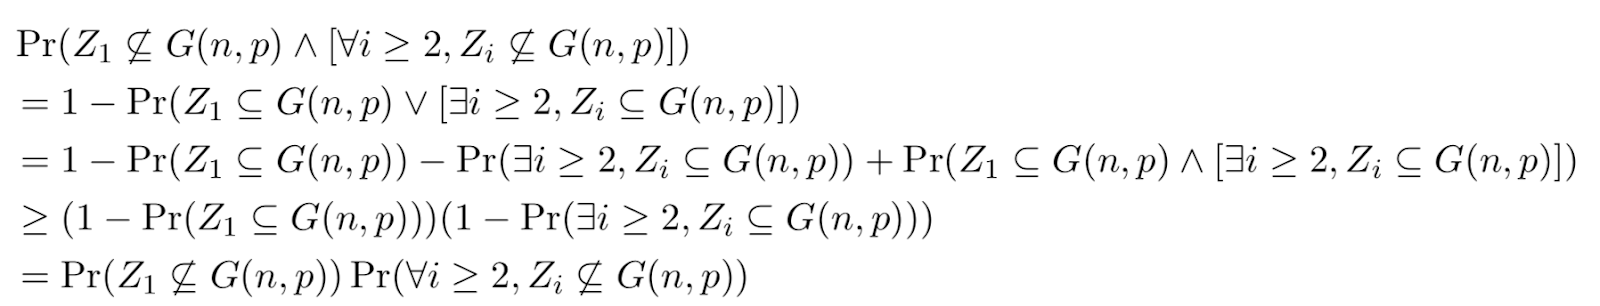2019年6月1日土曜日

閉路検出問題の計算複雑性

グラフ $H$ を固定し, $H$-Detection という問題を考えます. この問題はグラフ $G$ が入力で与えられたときに $G$ が $H$ を部分グラフとして含むかどうかを判定する問題です.
例えば, $H$ が長さ$|V(G)|$ の閉路だとするとこれはハミルトン閉路問題になるのでNP-困難です. 一方で $H$ が辺数 $|V(G)|/2$ のマッチングならば完全マッチングを含むかどうかの判定問題になるので, 多項式時間で解けます. それでは, どのような$H$に対して $H$-Detection は多項式時間で解けるのでしょうか?

この話はグラフアルゴリズムの分野でよく研究されている分野であり, 結論から言うと未解決なのですが, $H$のサイズをパラメータとしたときに$H$-Detectionは「木幅がunbounded ならばW[1]-困難である」という予想が有ります[1] (逆に木幅がboundedならばcolor codingでFPT時間で解けます). 本記事では $H$を様々な長さの閉路としたときどのような結果が知られているかについてまとめていきます. 基本的に$n=|V(G)|$, $m=|E(G)|$ とします.

$k$-cycle


一般の$k$に対しては color coding というアルゴリズムによって, $2^{O(k)}\cdot n^{\omega}$時間で解けます ($n\times n$の行列積が$O(n^{\omega})$ 時間でできるとします. 2019年6月1日現在では, $\omega\approx 2.373$ です).

$k$が定数だとしましょう. 実は, 現状では$k$の偶奇によって計算量が変わります. $k$が奇数のときはこれまで知られている最速のアルゴリズムは $O(n^{\omega})$ 時間です. 例えば $k=3$ の場合は隣接行列の3乗を計算して体格成分だけを見れば良いですね. 一方で$k$が偶数のときは, $O(n^2)$で解くアルゴリズムが知られています[2]. 例えば$k=4$の時は以下の単純なアルゴリズムで四角形を見つけることができます. ただし $N(u)$は頂点$u$の隣接頂点の集合とします.


このアルゴリズムでは配列 $\mathrm{T}[i][j]$ は二頂点$ij$間の長さ2のパスをカウントしていて, もし$\mathrm{T}[i][j]\geq 2$ なる$ij$が見つかったらその瞬間に四角形が有ると判定してアルゴリズムを終了します. 配列$\mathrm{T}$の各要素は高々2回しかアクセスされないはず (2回アクセスしたらその瞬間にアルゴリズムはtrueを返して終了する) なので, 計算時間は$O(n^2)$になるわけです.

また, 辺数$m$に関しては近年にもう少し早いアルゴリズムが知られていたり[2]して, 自分が把握する限りをまとめるとこんな感じになります.


ハミルトン閉路

ハミルトン閉路はTSPで使うDPを考えると$O(2^n n^2)$時間で解くことができるのですが, それでは$O(1.99^n)$時間で解けるのでしょうか? (乱択を許せば)できることが知られています[4]. アルゴリズムではまず, 入力のグラフ$G$を使ってある多変数多項式 $P$ を構成し, $P$が恒等的に$0$かどうかを乱択で判定するというものです. ここで構成する多項式$P$は, 「$P$が恒等的に0 iff グラフがハミルトン閉路を持つ」という性質を満たすようなものを上手く構成します. したがって多項式が恒等的に0かどうかの判定が出来る決定的アルゴリズムがあればハミルトン閉路の検出も決定的に出来るようになります. CyganらによるFPT algorithmの本[5]の10.4.2に分かりやすく解説されているので興味のある方はどうぞ.

[1]. M. Grohe, The complexity of homomorphism and constraint satisfaction problems seen from the other side, J. ACM, 2007.
[2]. R. Yuster and U. Zwick, Finding even cycles even faster, SIAM J. Discrete Math, (1997).
[3] S. Dahlgaard, M. B. T. Knudsen, M. Stöckel, Finding even cycles faster via capped k-walks, In Proc. of STOC2017.
[4]. A Björklund, Determinant sums for undirected Hamiltonicity, SIAM J. COMPUT., 2014.
[5]. M. Cygan, F. V. Fomin, Ł. Kowalik, D. Lokshtanov, D. Marx, M. Pilipczuk, M. Pilipczuk, S. Saurabh, Parameterized Algorithms, Springer Publishing Company, 2015.

2019年1月20日日曜日

離散確率空間上の確率集中不等式

本来, 確率変数は「ランダムな値をとる」ものであり, その挙動を予想することは困難です. しかし「n個の確率変数の和」といった幾つかのタイプの確率変数は「大体このくらいの値を高確率でとる(集中する)」ことが理論的に保証できます. この議論は確率集中不等式を用いてなされるものであり, 物理学, 機械学習, 計算機科学 (特に乱択アルゴリズムの解析), グラフ理論といった非常に広範囲な分野の理論的支柱の一つとなっています. 今回は離散確率空間上で成り立ついろんな確率集中不等式について紹介します.

この記事で紹介するのは Chernoff bound, Jansonの不等式, Kim-Vu polynomial concentration です. よくある確率集中不等式の本や連続の世界では Bernsteinの不等式, Azumaの不等式, Talagrandの不等式などが出てきますが, それらはここでは割愛します. Talagrandの不等式についてはめちゃくちゃ面白いので機会があれば紹介したいと思っています.

1. Chernoff bound


独立な確率変数の和の集中性を示す結果で, もっとも代表的なものです. $X_1,\ldots,X_n$を$[0,1]$の値をとる独立な確率変数で, $\mathrm{E}[X_i]=p_i$, $S=X_1+\cdots+X_n$, $\mu=E[S]$とします.

定理1 (Chernoff bound).
任意の $t>0$ に対して
$\Pr[S\geq \mu+t] \leq \exp\left(-\frac{t^2}{2(\mu+t/3)}\right)$.
任意の $t\leq \mu$ に対して
$\Pr[S\leq \mu-t] \leq \exp\left(-\frac{t^2}{2(\mu-t/3)}\right)$.


系2.
任意の$\epsilon>0$に対して,
$\Pr[S\geq (1+\epsilon)\mu] \leq \exp\left(-\frac{\min\{\epsilon,\epsilon^2\}\mu}{3}\right)$
及び
$\Pr[S\leq (1-\epsilon)\mu] \leq \exp\left(-\frac{\epsilon^2 \mu}{2}\right).$


Remark.
しばしば, $\Pr[S\geq (1+\epsilon)\mu] \leq \exp\left(-\Omega(\epsilon \mu)\right)$ などと勘違いされますが, これは $\epsilon\geq 1$ でないと成り立ちません. また, Chernoff boundには Hoeffidingなどいろんな亜種が知られていて, [1, 2]などが詳しいです. 特に

定理3.

独立なベルヌーイ試行 $X_1,\ldots,X_n$ に対して, $S=X_1+\cdots+X_n$, $\mu=\mathrm{E}[S]$とおく. 任意の $R\geq 2\mathrm{e}\mu$に対して
$\Pr[S\geq R]\leq 2^{-R}$
が成り立つ.

という結果も知られています[2, Corollary 10.4].

1.1. Chernoff bound の証明 (途中まで)


Chernoff boundの証明は初見だとビックリするようなアイデアに基づくものになっており, マルコフの不等式 ($\Pr[X>a]\leq \mathrm{E}[X]/a$) を使います. 概略だけ述べると

$\Pr[S\geq\mu+t] = \Pr[\exp(\lambda S)\geq \exp(\lambda(\mu+t))] \leq \exp(-\lambda(\mu+t))\mathrm{E}[\exp(\lambda S)]$

for any $\lambda\geq 0$ なので, 右辺の $\mathrm{E}[\exp(\lambda S)]$ を上から抑えることを考えます. ここで$S$は独立確率変数の和なので, 積に分解でき

$\mathrm{E}[\exp(\lambda S)]=\prod_{i=1}^n \mathrm{E}[\exp(\lambda X_i)] = \prod_{i=1}^n (1-p_i(1-\mathrm{e}^{-\lambda}))$

となります. (個人的には$\exp(\lambda S)$を考えるあたりがビックリポイントなのですが, モーメントなどをよくよく考えるとなんとなく自然に感じられるようになります). あとはこの右辺を気合いで上から抑えます. 具体的には

$\exp(\lambda x)\leq 1-x+x\exp(\lambda)$ for $x\in[0,1]$

という不等式を使います. この先は式変形を頑張って整理するだけです. 詳しく知りたい方は, 例えば [3, 21.4節] などをご覧ください.


2. Janson の不等式


Erdős–Rényiグラフ $G(n,p)$ を考えます. ここで$G(n,p)$ とは $n$ 頂点のグラフで各辺が独立に確率 $p$ で接続されて得られたグラフのことです. このグラフに含まれる三角形の個数を $Y$ とします. また, 辺$e$に対し, $X_e$を「$G(n,p)$が$e$を含んでいたら $1$, そうでなければ $0$」と定めます. すると

$Y=\sum_{u,v,w} X_{uv}X_{vw}X_{wu}$

と表せます. 一見すると確率変数の和なので Chernoff bound を使えば集中性が示せそうな気がしますが, 一般に $X_{uv}X_{uw}X_{wu}$と$X_{u'v'}X_{v'w'}X_{w'u'}$ は辺素でない限り独立じゃないのでChernoff boundは使えません. ただ, 辺素な三角形のペアは非常にたくさんあり, 従属関係がスパースなので集中性が示せるんじゃないかという気がします. このように独立な01確率変数上で従属関係がスパースな indicator の和に対し非常に強い下界を与えるのが Janson の不等式です. ちなみにLovász local lemmaも似たような設定を考えてます.

より一般に述べるために, 次の設定を考えます:
有限集合 $E$ で添字づけられた01確率変数の族 $(X_e)_{e\in E}$ を考えます. $\mathrm{E}[X_e]=p_e$ とし, 相異なる $e,f\in E$ に対して $X_e$ と $X_f$ は独立であるとし. $E$上の部分集合族 $\mathcal{E}\subseteq 2^E$ に対して確率変数 $Y_{\mathcal{E}}$ を

$Y_{\mathcal{E}}=\sum_{F\in\mathcal{E}} \prod_{e\in F} X_e$

と定めます. 三角形の例だと, $E$は$\binom{n}{2}$通りの辺の全体$\binom{V}{2}$であり, $X_e$ は $G(n,p)$ が辺$e$を含んでいるかどうかの indicator です. また, $\mathcal{E}$ は集合で書くと

$\mathcal{E}=\{\{a,b,c\}:a,b,c\in E$ are distinct. $\}$

です. すると $Y_{\mathcal{E}}$ は $G(n,p)$が含む三角形の個数になります.


定理4 (Jansonの不等式).

任意の $t>0$ に対し以下が成り立つ:

$\Pr[Y_{\mathcal{E}}\leq \mathrm{E}[Y_{\mathcal{E}}]-t] \leq \exp\left(-\frac{t^2}{\nabla}\right)$.

ここで $\nabla$は

$\nabla=\sum_{F_1,F_2\in\mathcal{E}:\,F_1\cap F_2\neq\emptyset} \mathrm{E}[\prod_{e\in F_1\cup F_2} X_e]$.


2.1. 三角形の個数の下界の導出


$\mathcal{E}$を, 冒頭で述べたように三角形の辺集合の全体と定めます. まず期待値 $\mathrm{E}[Y_\mathcal{E}]$を評価してみると,

$\mathrm{E}[Y_{\mathcal{E}}]=\binom{n}{3}p^3\approx \frac{(np)^3}{6}$

が得られます. 次に定理4に出てくる $\nabla$ を評価します. 式はややこしそうに見えますがやることは簡単で, 辺を共有する二つの三角形$F_1,F_2$に関して $p^{|F_1\cup F_2|}$ を足しあげるだけです. 実際, indicatorの期待値は確率と等しく, 総和の中の $\mathrm{E}[\prod_{e\in F_1\cup F_2} X_e]$ は今回の例でいうと $F_1$と$F_2$の辺が全て $G(n,p)$ に現れる確率と等しくなるので, $p^{|F_1\cup F_2|}$ となります.

ここで $F_1,F_2$ は辺を共有するので, $|F_1\cup F_2|\leq 5$です. そこで三つの場合を考えます:
(i). $|F_1\cup F_2|=3$ の場合: このとき, $F_1=F_2$は同じ三角形を表すので, このような組$(F_1,F_2)$は全部で $O(n^3)$ 通りあります.

(ii). $|F_1\cup F_2|=4$ の場合: そもそも辺を共有する三角形で$|F_1\cup F_2|=4$となるものは存在しません.

(iii). $|F_1\cup F_2|=5$ の場合: $F_1$は三角形の全体$\mathcal{E}$から選ばれるので, $O(n^3)$通りの選び方があります. 一方で$F_2$は$F_1$と一本だけ辺を共有するため, 下図のような感じになります. すると $F_2$ の頂点の自由度は $1$ なので, $F_1$を固定したとき$F_2$は $O(n)$ 通りしかとれません. 従って組 $(F_1,F_2)$ は$O(n^4)$通りです.
Case (iii) における二つの三角形 $(F_1,F_2)$ に対して $F_1\cup F_2$ が表すグラフ.


以上より, $\nabla$は

$\nabla = O(n^3)p^3+O(n^4)p^5 = O(n^3p^3(1+np^2))$

となります. これを定理4 に代入すると,

$\Pr\left[Y_{\mathcal{E}} \leq \mathrm{E}[Y_{\mathcal{E}}]-t\right] \leq \exp\left(-\Omega\left(\frac{t^2}{(np)^3(1+np^2)}\right)\right)$

が得られます. 例えば $t=\mathrm{E}[Y_{\mathcal{E}}]\approx \frac{(np)^3}{6}$を代入すると,

$\Pr[G(n,p)$が三角形を含まない$]\leq \exp\left(-\Omega\left(\frac{(np)^3}{1+np^2}\right)\right) \leq \exp(-\Omega((np)^2))$

となるので, $p\geq \Omega(n^{-2/3})$ならば, $G(n,p)$ は指数的に高い確率で三角形を含む, ということが結論づけられます.

Remark.

実は Janson の不等式は多くの場合で指数部分が定数倍を除くとタイトなバウンドを与えていることが知られており[5], 非常に強力な不等式であることがわかります.

備忘録.

証明はChernoff boundと同様に $\mathrm{E}[\exp(-\lambda Y)]$ のバウンドをうまく与えるのですが, 独立性が成り立たないのが辛いポイントで, 「とりあえず$\lambda$で微分」「アイテム$e$を固定し, $X_e$と独立な部分和とそうでない部分和に分けて, 独立でない部分和に関してはFKG不等式を使ったり」などを工夫します.


3. The Kim-Vu polynomial concentration


文献[4]で示された定理を紹介します. 一般的な呼称がわからないのですが自分はとりあえず表題の通り呼んでいます. 2節で用いたセッティングをここでも流用します. すなわち, 台集合 $E$ 上の独立01確率変数 $(X_e)_{e\in E}$ と部分集合族 $\mathcal{E}\subseteq 2^E$ に対して, 新たな確率変数

$Y_{\mathcal{E}}=\sum_{F\in\mathcal{E}} w_F\prod_{e\in F} X_e$

の集中性を考えます. ここで $w_F>0$ は重みです. 2節では Janson の不等式を用いて下界だけ示しましたが, この節では集中性を述べる結果を紹介します. 上界も求められるためJansonより汎用性は高いように見えますが, 得られるバウンド自体は Janson よりも少し弱い結果になります.

ここでは, $Y_{\mathcal{E}}$ は $X_e$ を変数として見たとき多変数多項式になっていることに着目します. この節で紹介する定理は, この多項式の次数が小さいときに有効な結果になります.

準備として, 縮約について述べます. 部分集合 $A\subseteq E$ に対して, 確率変数 $Y_A$ を

$Y_A=\sum_{F\in\mathcal{E}:A\subseteq F} w_F \prod_{e\in F\setminus A} X_e$

と定めます. $A$を含むような$F$について, $A$以外の要素を掛けて足し上げているので, $Y_A$ は $Y_{\mathcal{E}}$ の $A$による縮約とみなすことができます.

例えば $\mathcal{E}$ を 前節で考えた三角形をなす辺集合の族とし, $A=\{\{1,2\}\}$ を辺$12$のみからなる集合としましょう (今は大集合$E$は$\binom{n}{2}$個の辺集合であることに注意). すると, $Y_A$ は辺$\{1,2\}$を含む三角形 $F$ に対して 辺$\{1,2\}$を除去して足し上げたものになっているため,

$Y_A = \sum_{u\in V\setminus\{1,2\}} X_{1,u}X_{2,u}$

となります. イメージとしては $G(n,p)$ が 辺集合$A$ を含むという事象を条件つけたときの $Y_{\mathcal{E}}$ を表しています.


定理5 (The Kim-Vu polynomial concentration).

$Y_{\mathcal{E}}$ を $k$ 次多項式とする. すなわち, 任意の $F\in\mathcal{E}$ に対して $|F|\leq k$ が成り立つとする. $a_k=8^k\sqrt{k!}$とし,
$\Xi(\mathcal{E})=\max_{A\subseteq E}\mathrm{E}[Y_A]$,
$\Xi'(\mathcal{E})=\max_{\emptyset\neq A\subseteq E}\mathrm{E}[Y_{A}].$
と定める. 任意の$\lambda>1$に対して

$\Pr\left[|Y_\mathcal{E}-\mathrm{E}[Y_{\mathcal{E}}]|\geq a_k \sqrt{\Xi(\mathcal{E})\Xi'(\mathcal{E})}\lambda^k\right]\leq O(\exp(-\lambda+(k-1)\log n))$

が成り立つ.


3.1. $G(n,p)$ が含む三角形の個数の集中性


三角形の個数は $Y_{\mathcal{E}}$ として表せるため, 定理5により集中性が示せます. $A\subseteq E$に対して $\mathrm{E}[Y_A]$ を評価する必要がありますが, $A$を一辺 $\{1,2\}$ のみからなる集合のとき, 冒頭の例で述べた事実を使うと

$\mathrm{E}[Y_A]= \sum_{u\in V\setminus \{1,2\}} p^2 = O(np^2)$

となります. $A=\{\{1,2\},\{1,3\}\}$ ならば, $A$を含む $F$ としては三角形123しかありえないので, $\mathrm{E}[Y_A]=p$ です. つまり, $A$は増えれば増えるほど $Y_A$ は減っていく一方なので, 

$\Xi(\mathcal{E})=\max_{A\subseteq E}\mathrm{E}[Y_A]=O(n^3p^3)$,
$\Xi'(\mathcal{E})=\max_{\emptyset\neq A\subseteq E}\mathrm{E}[Y_{A}]=O(np^2)$

が成り立ちます. これを定理5に突っ込むと

$\Pr\left[|Y_{\mathcal{E}}-\mathrm{E}[Y_{\mathcal{E}}]|\geq  \Theta(n^2p^{2.5})\lambda^3\right] \leq O(\exp(-\lambda+2\log n))$

となります. 例えば $\lambda=3\log n$ を代入すると, 確率 $1-O(n^{-1})$ で

$\frac{(np)^3}{6}-O(n^2p^{2.5}(\log n)^3) \leq $三角形の個数 $\leq \frac{(np)^3}{6}+O(n^2p^{2.5}(\log n)^3)$

が成り立つことが簡単に示せます.


[1]. Concentration Inequalities and Martingale Inequalities: A Survey, F. Chung, and L. Lu, Internet Mathematics Vol. 3, No. 1: pp. 79-127 (2006).

[2]. Probabilistic Tools for the Analysis of Randomized Optimization Heuristics, B. Doerr, arXiv:1801.06733, (2018).

[3]. Introduction to Random Graphs, A. Frieze, and M. Karoński, Cambridge University Press, (2016).

[4]. Concentration of multivariate polynomials and its applications, J. H. Kim, and V. H. Vu, Combinatorica, Vol. 20, No. 3, pp. 417-434 (2000).

[5]. The lower tail: Poisson approximation revisited, S. Janson, and L. Warnke, Random Structures and Algorithms, Vol. 48, No. 2, pp. 219-246 (2014).

2019年1月19日土曜日

マトロイドの基の数え上げの決定的多項式時間近似アルゴリズム

$\mathcal{M} = (E,\mathcal{B})$ をマトロイドとします. ここで $E$ は台集合で$|E|=n$を満たし, $\mathcal{B}$ は基の全体とします. マトロイドの独立性オラクルが与えられたとき, $|\mathcal{B}|$ を求めるという問題を考えます.

マトロイドの数え上げは例えばグラフの全域木の総数やグラフのreliability (分配関数みたいなもの)の計算を求める問題を含んでおり, かなり多くの研究結果があります. 今回の記事では

Log-Concave Polynomials I: Entropy and a Deterministic Approximation Algorithm for Counting Bases of Matroids

という論文の内容について, 簡略に紹介したいと思います. ここで載せたリンクはarXivのものですが, この論文はFOCS 2018に採択されています[1]. 論文そのものはlog-concave polynomialという凄い道具について解析をしており, その一つの応用としてマトロイドの数え上げ近似をするという内容なのですが, 凄い道具の解析は凄い難しく私も咀嚼しきれていないため, 本記事では凄い道具をどのように使って数え上げ近似をするのかについて焦点を絞ります.

論文の概要: log-concave polynomialに関する理論を築いた. その帰結として, ランク $r$ に対して, 独立性オラクルの下でマトロイドの基の総数の$2^{O(r)}$-近似を出力する多項式時間決定的アルゴリズムを与えた. 二つのマトロイドの共通基の個数も同様の近似比のアルゴリズムを与えた. 近似解はマトロイドの基多面体上のある最適化問題を解くことによって得られる.


0. マトロイドの基の数え上げについて


マトロイドの基の数え上げは割と長く研究されていて, これまでは Balanced matroid と呼ばれるクラスのマトロイドに対してはMCMCに基づく多項式時間乱択近似アルゴリズムが知られていました. この辺の話題はNIPS2018のチュートリアルでも関連した話題が取り扱われており, 注目の高さが伺えます.

グラフの全域木の総数は行列木定理により簡単に数えることが出来ます. ではこれを拡張してマトロイドの基は数えられるのでしょうか?

結論から言うとマトロイドの基の数え上げはとても難しいと信じられています. 具体的に言うとバイナリマトロイドの基の数え上げは#P-困難であることが知られています. 従って方向性としては近似アルゴリズムを考えるのが自然です. しかし近似率にも下界が知られており, 独立性オラクルモデルを多項式回呼び出すどんな決定的アルゴリズムも近似比は (P≠NPとは独立に) $2^{\Omega(n/(\log n)^2)}$になることが知られています [2]. この結果の系として, ランク $r\gg\log n$であれば近似比の下界

$2^{\Omega(r/(\log n)^2)}$          ...(1)

が導出されます.

冒頭で述べた通り, balanced matroidと呼ばれるクラスのマトロイドに対してはMCMCに基づく近似アルゴリズムが知られています[3]. 用語を知っている人向けに言うと, このアルゴリズムは
Balanced matroid ならば $\mathcal{M}$ とそのいかなるマイナーに対してもnegative correlationが成り立つので, base exchange graph上のランダムウォークにより基の(近似的な)一様サンプリングが可能になる. そこで Jerrum, Valiand and Vaziraniによる有名な結果 (サンプリングと数え上げ近似の関係) を使うと基の数え上げの近似が出来る.

という流れになっています. 噛み砕いて言うとbalanced matroidだと base exchange graph ($\mathcal{B}$が頂点集合で, 基交換公理によって行き来できる基同士を辺で結んだ巨大なグラフ) がエクスパンダーになっていて定常分布(ここでは一様分布)に早く収束し, 基の一様サンプリングが出来ます. そして実は一様サンプリングが出来れば数え上げで良い近似が出来るという結果が元からあるのでそれを使って数え上げの近似を行う, という流れです. 一般のマトロイドに対して base exchange graph がエクスパンダーかどうかはMihail-Vazirani 予想と呼ばれ, 長年未解決でしたが, 近年解決されたそうです (2019年1月時点ではarXiv上ですが).

重要な用語の定義を述べていきます. サイズ $n$ の台集合$E$上の集合族 $\mathcal{S}$ 及び $\mathcal{S}$上の確率測度 $\mu$ に対して

$g_\mu (x_1,\ldots,x_n) := \sum_{F\in \mathcal{S}} \mu(F)\prod_{e\in F} x_e$

という関数を定めます. この関数を $\mu$ の generating polynomial と呼びます. 以下では特に$\mathcal{S}$に属する任意の集合がサイズ$r$であるような場合のみを考えます (例えばマトロイドの基族). これまで知られている結果として, この関数が $\mathrm{Im}(x_i)>0$ for every $i=1,\ldots,n$ なる任意の点 $\mathbf{x}=(x_1,\ldots,x_n)$に対して $g(\mathbf{x})\neq 0$ を満たす (この性質を real stable と呼びます) ならば, $\mu$に対して自然に定義される$\mathcal{S}$上のランダムウォークは定常分布$\mu$に収束するというのがあります. これによって数え上げの近似っぽいことが出来ます.
マトロイドの基上の一様分布に対するgenerating polynomialがreal stableであればそのマトロイドがbalancedであるということが知られています.

ここまでで述べたように, 基の数え上げに対するアルゴリズムとしてはMCMCに基づくものが基本形でした (特定のマトロイドに関してはad-hocに数え上げるアルゴリズムは存在する). しかし今回紹介する論文では, 決定的なアルゴリズムで近似比が $2^{O(r)}$ となるものを提案します. これは近似比の下界(1)と比較すると右肩にちょっとだけギャップがありますが, とても面白いアルゴリズムです.


1. エントロピーを用いた$|\mathcal{B}|$の近似


情報理論や物理学ではエントロピーという概念がよく知られています. ここでは, 基族上の確率測度 $\mu:\mathcal{B}\to\mathbb{R}_{\geq 0}$ に対して

$H(\mu)=\sum_{F\in\mathcal{B}}\mu(B)\log\frac{1}{\mu(B)}$

をエントロピーと呼びます. もし$\mu$が$\mathcal{B}$上の一様分布ならば, $H(\mu)=\log|\mathcal{B}|$ が成り立ちます. もしもランク$r$のマトロイドの基族$\mathcal{B}$上の一様分布$\mu$に対し,
$H(\mu)-r \leq \beta \leq H(\mu)$
を満たす $\beta$ が計算できたとすると, $\exp(\beta)$ は $|\mathcal{B}|$ の$2^{O(r)}$-近似になっています. この$\beta$を計算することを考えます.

台集合$E$の要素 $e\in E$ に対し, $\mu_e:=\mu(\{F\in\mathcal{B}:F\ni e\})$ と定めます. つまり$\mu_e$はアイテム$e$を含む確率 (marginal probability) に対応しています. 論文中では次の結果を証明しています:

Theorem 1.
もしも$\mu$の generating polynomial $g_\mu$ が log-concaveならば, そのエントロピー $H(\mu)$ について, $H(\mu)\geq \sum_{e\in E} \mu_e\log\frac{1}{\mu_e}$ が成り立つ.

Theorem 2.
マトロイドの基族$\mathcal{B}$上の一様分布$\mu$に対応する generating polynomial は log-concave である.

また, エントロピーの劣加法性より, 以下の事実が簡単に確認できます:

Proposition 3.
$H(\mu) \leq \sum_{e\in E}\left(\mu_e\log\frac{1}{\mu_e}+(1-\mu_e)\log\frac{1}{1-\mu_e}\right)=\sum_{e\in E}H(\mu_e)$.

ここで, 関数 $f:x\mapsto (1-x)\log\frac{1}{1-x}$ は $0\leq x\leq 1$に対して $f(x)\leq x$が成り立ちます. 従って, ランク$r$のマトロイドの基族$\mathcal{B}$を考え, $x=\mu_e$を代入して$e\in E$について総和をとると,

$\sum_{e\in E}\mu_e\log\frac{1}{1-\mu_e}\leq \sum_{e\in E}\mu_e \leq \sum_{F\in\mathcal{B}}r\cdot \mu(F)=r$

が得られます. ここで Theorem 1 と Proposition 3 を組み合わせると,

$\sum_{e\in E}(1-\mu_e)\log\frac{1}{\mu_e}\geq H(\mu)-r$

となるので, 系として

Corollary 4.

ランク$r$のマトロイドの基族$\mathcal{B}$上の分布$\mu$に対し, その generating polynomial が log-concave ならば,

$H(\mu)\geq \sum_{e\in E}\mu_e\log\frac{1}{\mu_e}\geq H(\mu)-r$

が成り立つ.


2. 提案アルゴリズム


前節の結果より, marginal probability $\mu_e$ を計算出来れば良いのですが, それはそもそも「アイテム$e$を含む基の個数は?」という問題の答えになっているため, 基の数え上げよりも難しそうです. そこで$\mu_e$を計算せずに済む方法を考えます.

マトロイド$M$の基族 $\mathcal{B}$ 上の一様分布 $\mu$ に対して, $n$次元ベクトル $(\mu_e)_{e\in E}=(\mu_1,\ldots,\mu_n)$ を考えると, 基多面体 $\mathcal{P}_M$ に属する点の一つになっていることがわかります. ここで, 基多面体とは, それぞれの基の indicator vector の凸包として定義されます.

$(\mu_1,\ldots,\mu_n) = \frac{1}{|\mathcal{B}|}\sum_{F\in \mathcal{B}} 1_F$

より確かに marginal distribution のなすベクトルは基多面体$\mathcal{P}_M$内の点に含まれています. そこで, 次の最適化問題を考えます:

maximize: $\sum_{i=1}^n H(p_i)$
s.t.
     $(p_1,\ldots,p_n)\in \mathcal{P}_M$.

Proposition 3より, この問題の最適値 $\beta$ は求めたいエントロピー$H(\mu)=\log|\mathcal{B}|$の上界になっています. しかも, 目的関数は$p$について凹関数になっており, マトロイドの独立性オラクルがあれば$\mathcal{P}_M$上で分離オラクルが構成でき, 楕円体法を用いて多項式時間で解くことができます.

次に, 最適解 $p\in\mathcal{P}_M$ を考えます. 実は(論文中で示されているのですが) marginal distributionが$p$となるような$\mathcal{B}$上の分布$\hat{\mu}$で, generating polynomial $g_{\hat{\mu}}$が log-concave となるものが構成出来ます (つまり, $p_e=\hat{\mu}_e$が成り立つ). この$\hat{\mu}$に対して Corollary 4を適用すると,

$H(\hat{\mu})\geq \sum_{e\in E}\hat{\mu}_e\log\frac{1}{\hat{\mu}_e}=\sum_{e\in E}p_e\log\frac{1}{p_e}\geq \sum_{e\in E}H(p_e)-r\geq H(\mu)-r$.

更に, $H(\hat{\mu})\leq H(\mu)$ が成り立つ (一様分布$\mu$がエントロピーを最大化する) ので, 結果として, 最適化問題の最適値$\beta$に対して

$\beta-r \leq H(\mu)=\log|\mathcal{B}|\leq \beta$

が成り立つので, 近似比 $2^{O(r)}$ が成り立ちます.


3. まとめ


アルゴリズムは単純ですが, 近似比の保証において「generating polynomial $g_\mu$ が log-concaveならば〜」というステートメントが多く出ています. ここで紹介した論文の貢献としては log-concave function の解析にあって, 提案アルゴリズムはその応用先の一つでしかありません (とはいっても重要な結果です). 著者たちは更に別の続編とも言うべき論文 (こちらは2019年1月時点ではarXivに上がっているだけですが) で, Mihail-Vazirani 予想を解決しマトロイドのbase の数え上げに対してMCMCに基づく FPRAS を提案しており, 今後も離散の世界における log-concave 性が発展していくことになるかと思います (連続の世界ではlog-concave はすでに注目されていていろんなことが知られています).


[1]. Log-concave polynomials, entropy, and a deterministic approximation algorithm for counting bases of matroids, N. Anari, S. O. Gharan, and C. Vinzant, In Proceedings of the 59th Annual Symposium on Foundations of Computer Science (FOCS) , 2018.

[2]. On the problem of approximating the number of bases of a matroid, Y. Azar, A. Z. Broder, and A. M. Frieze, Information Processing Letters Volume 50, Issue 1, 1994.

[3]. Balanced matroids, T. Feder, and M. Mihail, In Proceedings of the 24th Annual ACM Symposium on Theory of Computing (STOC), 1992.


2018年11月10日土曜日

color-codingと脱乱択化

乱択アルゴリズムとは, ランダムネスの力を上手く活用したアルゴリズムのことで, ここでは「必ず多項式時間で終わるが間違った解を出力するかもしれない」というタイプのアルゴリズムを考えます(モンテカルロアルゴリズム).

本記事では, パラメタ化計算量の分野で有名な乱択アルゴリズムとしてcolor coding[4]を紹介し, その「脱乱択化」の方法 (perfect hash family) を紹介します.

1. color coding


1.1. 背景 (k-PATH)


グラフGが与えられたとき, それが長さkのパスを持つかを判定する問題(k-PATH)を考えます. パスは同じ頂点を二度通らないことに注意してください. $k=n-1$ のとき, ハミルトンパスの判定問題を表現するのでこの問題は $k$ を入力としたときはNP完全となります. 一方で $k=O(1)$ としたときは $n^k$ 時間, すなわち多項式時間で解くことが出来ます. それでは, $k=O(\log n)$ の時は多項式時間で解けるでしょうか? $k=\sqrt{n}$ のときはどうでしょうか? 結論から言うと, $k=O(\log n)$ならばk-PATHは多項式時間で解けますが, $k=\omega(\log n)$の場合は(ETHの下で)多項式時間で解けないだろうと予想されています. color codingを使うと, k-PATHを $2^{O(k)}\cdot n^{O(1)}$ 時間で解くことができます. 以下のそのアルゴリズムを紹介していきますが, 同じ内容は吉田 悠一さんによるこちらの記事にも非常に分かりやすく載っているので紹介させていただきます.


1.2. アルゴリズム


1. 与えられたグラフ $G=(V,E)$ の各頂点をランダムに $k+1$ 色で塗ります. つまり, 各頂点に対して$\{1,\ldots,k\}$から一様ランダムに一つの値を選択しその値の色で塗ります.


2. 色付きグラフ $G=(V,E)$ がカラフルな k-path を含むかどうかを判定します. カラフルなk-path とは, 長さkのパスであって各頂点の色が全て異なる (i.e., $k+1$ 種類の色全てを含む) ようなものです. もしカラフルな k-path を含んでいたら, 元のグラフ $G$ は k-path を含むので終了し, そうでなければステップ1に戻ります.


1.3. アルゴリズムの解析


与えられたグラフ $G=(V,E)$ が k-path を含んでいたとして, その頂点を $v_1,\ldots,v_{k+1}$ としましょう. これらの $k+1$ 個の頂点がカラフルになる確率は

$\frac{k!}{k^k} \approx \sqrt{2\pi k} \exp(-k) \leq 3^{-k}$

となります (スターリングの近似を用いました). したがって上述のステップ1-2を $9^k$回繰り返したとき, パス$(v_1,\ldots,v_{k+1})$が毎回カラフルにならない確率は

$(1-3^{-k})^{9^k} \leq \exp(-3^{-k}\cdot 3^{2k}) = \exp(-3^k)$

となり, 非常に小さくなります (ここでは $1+x\leq \mathrm{e}^x$を用いました). つまり非常に高確率で, $9^k=2^{O(k)}$回の繰り返しの中で一回は k-path はカラフルになり, ステップ2で検出されるので高確率でk-PATHを解くことができることになります.


1.4. カラフルなk-パスの検出


動的計画法を使ってカラフルなk-パスの検出を $O(2^k\cdot n^3)$ 時間で解くことが出来ます. 二頂点$u,v\in V$および色の集合$S\subseteq \{1,\ldots,k+1\}$に対して配列として

$\mathrm{T}[u][v][S]:=$頂点$u$から$v$への, $S$-カラフルなパスが存在すればtrue, そうでなければfalse.

と定めます. ここで $S$-カラフルなパスとは, $|S|$個の頂点からなるカラフルなパスで, 各$c\in S$に対して色$c$で塗られた頂点を一個だけ含むようなものです (下図参照).


色つきグラフ$G$において$N(v)$で頂点$v$の隣接点の集合を表し, $\chi(v)\in \{1,\ldots,k+1\}$で$v$の塗られた色を表すこととします.
すると, $\mathrm{T}[u][v][S]$に対して以下の漸化式が成り立ちます.

$\mathrm{T}[u][v][S]=\bigvee_{w\in N(v)}\mathrm{T}[u][w][S-\{\chi(v)\}]$.

basic caseとして $\mathrm{T}[v][v][\{\chi(v)\}]=\mathrm{true}$ と定めます. また, 自明ですが$\{\chi(u),\chi(v)\}\not\subseteq S$ならばT[u][v][S]=falseです. これにより, カラフルk-パスの判定は$O(2^kn^3)$時間で解けるので, アルゴリズム全体では$9^k\cdot n^3=2^{O(n)}\cdot n^{O(1)}$時間で解けます ($n$の右肩の値はおそらく$2$になると思いますが, 大雑把に見積もっても高々$3$なのは明らかなので今回はそう記しました).


1.5. その他の問題への応用


k-PATH以外にもk-CYCLE (長さkの閉路の検出問題) といった問題も color coding を応用したアルゴリズムによって $2^{O(k)}\cdot n^{O(1)}$時間で解くことができます. 一般に, 入力で与えられたグラフ$G$が頂点数$k$の別のグラフ$H$を含むかどうかは 全探索により$O(n^{k+O(1)})$時間で解けますが, color codingを使うと $2^{O(k)}\cdot n^{O(\mathrm{tw})}$ 時間で解くことが出来ます (twは$H$の木幅です). したがってtwが定数ならば$2^{O(k)}\cdot n^{O(1)}$時間で解けます.


1.6. k-PATHに対するより早いアルゴリズム (advanced topic)


P≠NP予想より強いETHという予想を仮定すると, k-PATH問題は$2^{o(k)}\cdot n^{O(1)}$時間では解けないことが知られています[1]. 今回紹介したcolor coding では$9^k\cdot n^3$時間でしたが, 解析をちゃんとやると $O(\mathrm{e}^kn^3\log n)$時間でwith high probability (i.e., 適当な定数$\epsilon>0$に対し確率 $\geq 1-n^{-\epsilon}$) で正解するアルゴリズムになるはずです. では, 例えば$2.3^k\cdot n^{O(1)}$時間で解けるのでしょうか?

結論から言うと, $2^{k}\cdot n^{O(1)}$時間の乱択アルゴリズムが存在します[2]. このアルゴリズムは
1. 「グラフがk-pathを含まない iff Pは恒等的に0」となる多項式Pを構成する (但しガロア体$\mathrm{GF}(2^{\lceil 4k \rceil})$上の多項式).
2. Schwartz-Zippelの補題を用いてPが恒等的に0かどうかを乱択で判定する (その際に包除原理を用いる).
という流れです. Schwartz-Zippelの補題については相馬 輔 さんによる こちらのページで証明も含めて紹介されています. 更に, 現在では$2^{0.75k}\cdot n^{O(1)}$ 時間アルゴリズムも知られています[3].

この$2^{k}\cdot n^{O(1)}$時間アルゴリズムは様々な道具が登場し非常に面白いものなので, 機会があれば紹介したいと思います.


2. 脱乱択化 (derandomization)


脱乱択化とは文字通り「ランダムネスを排除する」ことです. これまで考えていたアルゴリズムは高確率で正解を計算するものでしたが, 脱乱択化をすると必ず正解を計算するアルゴリズムになります. 計算量理論では, 多項式時間の乱択モンテカルロアルゴリズムで(高確率で)解ける問題のクラス (BPP) が多項式時間で決定的に解ける問題のクラス(P) と等しいかどうかは未解決ですが, 多くの研究者はP=BPPだと信じているようです. P=BPPならば多項式時間乱択アルゴリズムは多項式時間のまま脱乱択化できる, ということになります. ここでは, それに関連したポジティブな結果の一つとして, 先ほど紹介したcolor codingの脱乱択化の方法について紹介します. キーワードはperfect hash familyです.


2.1. color coding is revisited


color codingに基づくアルゴリズムは
(i) グラフを$k$色で塗る.
(ii) カラフルな部分グラフを動的計画法で$2^{O(k)}\cdot n^{O(1)}$時間で見つける.
(iii) 見つけたい部分グラフが(i)でカラフルになる確率が$\geq 2^{-O(k)}$となるので, $2^{O(k)}$回(i)と(ii)を繰り返す.
というものでした.

即ち, 「見つけたい部分グラフが(i)でカラフルになるような塗り分け」をランダムネスを使わず決定的な方法で見つけられたら脱乱択化になります. 


2.2. Perfect hash family


入力で与えられるグラフを$G=(V,E)$とし, その頂点数を$n=|V|$とします. そして塗り分けの集合 $\mathcal{F}$ を考えます. $[m]:=\{1,\ldots,m\}$と表すことにすると, 各要素 $f\in \mathcal{F}$は写像$f:[n]\to [k]$となり, $f(v)$は頂点$v$の色を意味します. つまり$\mathcal{F}$は写像の集合になります. 

定義.
$\mathcal{F}$ が以下の条件(*)を満たすとき, $\mathcal{F}$は $(n,k)$-perfect hash familyと呼びます.
(*) サイズ$k$の任意の部分集合$S\subseteq [n]$ of $|S|=k$ に対して, ある$f\in\mathcal{F}$が存在して, $f(S)=[k]$となる (i.e., 塗り分け$f$の下では$S$はカラフルになる).

$\mathcal{F}$ を $(n,k)$-perfect hash family としましょう. グラフ$G=(V,E)$が入力で与えられたとき, $\mathcal{F}$を構成して全ての$f\in \mathcal{F}$のそれぞれに対してcolor codingの動的計画法のアルゴリズムを使ってカラフルな部分グラフを判定すれば, $T(n,k)+|\mathcal{F}|\cdot 2^{O(k)}\cdot n^{O(1)}$時間で決定的に解くことが出来ます. ここで$T(n,k)$は$\mathcal{F}$の構成にかかる時間です.

$(n,k)$-perfect hash familyについては以下の結果が知られています[4]:

定理.
$(n,k)$-perfect hash family $\mathcal{F}$で
$|\mathcal{F}|\leq \mathrm{e}^kk^{O(\log k)}\log n$
を満たすものを $\mathrm{e}^kk^{O(\log k)}n\log n$ 時間で構成することができる.


これにより, color codingの脱乱択化を$O(\log n)$時間程度のロスでやることが出来ます.


参考文献


[1] D. Lokshtanov, D. Marx, and S. Saurabh. Lower bounds based on the Exponential Time Hypothesis. Bulletin of the EATCS, 84, pp.41–71, 2011.

こちらのサーベイ論文は(題目通り)ETHやSETHの基づいたlower boundとその証明テクニックを幅広く紹介しており, 大変良い論文です. SETHについては以前の記事で紹介しています.

[2] R. Williams, Finding a path of length $k$ in $O^*(2^k)$ time, Journal Information Processing Letters, 109-6, pp. 315-318, 2009.

color codingではk-PATHを$\mathrm{e}^k n^{O(1)}$時間でしたが, こちらの論文はSchwartz-Zippelの補題を用いて$O(2^{k}n^{O(1)})$時間でk-PATHを解くアルゴリズムを提案しています.

[3] M. Cygan, F. V. Fomin, L. Kowalik, D. Lokshtanov, D. Marx, M. Pilipczuk, M. Pilipczuk S. Saurabh, Parameterized Algorithms, Springer International Publishing, 2015.

パラメタ化計算量に関するアルゴリズムを幅広く紹介しています. FPTといった計算量クラス基本的な定義やW-階層といった困難性のクラスやそれらに基づくlower boundについても載っています. 各chapterの後ろには豊富な演習問題とBibliographic notesが載っており, ここには計算量の改善の歴史などが載っています. 誤植もあまりなく, 英語も読みやすいため個人的には非常にオススメの本です.

[4] N. Alon, R. Yuster, U. Zwick, Color-coding, J. ACM, 42-4, pp. 844-856, 1995.

color codingを提案した非常に有名な論文です. 論文中では$k$-CYCLE (長さ$k$の閉路の検出) を用いてcolor codingのアルゴリズムを説明していますが, それのみならず, 木幅が定数のグラフの検出, perfect hash familyを用いた脱乱択化についても書かれています.

2018年9月3日月曜日

FKG不等式とその解釈

FKG不等式という不等式を紹介します.
私自身そこまで詳しくはなく, 考えていたら面白い解釈を思いついたので記事に起こした次第です.
形がシンプルで, よく考えると劣モジュラ性に現れる限界効用逓減性っぽい雰囲気が感じられ, さらに名前がカッコイイので個人的に激アツな不等式です.

準備

・$\{0,1\}^m$上の離散確率を考える (例えばErdős–Rényi model).
・$f,g:\{0,1\}^m \to \mathbb{R}_{\geq 0}$ ... monotone increasing ($\{0,1\}^m$上の順序はbitwiseで比較)
・各$i=1,\ldots,m$に対してbinaryな確率変数$X_i$を定め, $\Pr(X_i=1)=p_i$とする.
・このとき, $f(X_1,\ldots,X_m)$ と $g(X_1,\ldots,X_m)$ は確率変数となる. 

定理 (FKG不等式)


$\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]$.
実は$\{0,1\}^m$は束にまで一般化できる. 


Remark.
・$f,g$がどちらも monotone decreasing でも成り立ちます (両辺に $-f,-g$ を代入).
・要するに共分散 $\mathrm{Cov}[fg]\geq 0$ と言っているだけなので, 両方ともmonotone ならば正の相関がある, みたいな認識です.


例 (Erdős–Rényi modelの部分グラフ)


$f,g$としてindicator functionを考えるのが一番簡単でしょう.
$m=\binom{n}{2}$, $p_i=p\in[0,1]$とすると, この設定はErdős–Rényi model $G(n,p)$と同等になる. その頂点集合を$V=[n]=\{1,\ldots,n\}$と定め, $Z_1,\ldots,Z_k\subseteq E(K_n)$を$V$上の完全グラフ$K_n$の辺部分集合とする.

例えば, 二頂点$s,t\in V$を固定し$Z_1,\ldots,Z_k$を$st$を結ぶ長さ4のパスの全体を考えたりできます. ここで各$Z_i$は頂点にラベルがついていることに注意してください. 従ってこの例だと$k=(n-2)(n-3)(n-4)$となります.

ここで確率
$\Pr(\forall i,Z_i\not\subseteq G(n,p))$
を考えます. FKG不等式を用いると
$\Pr(\forall i,Z_i\not\subseteq G(n,p))\geq \prod_i \Pr(Z_i\not\subseteq G(n,p))$
が簡単に示せます (実は使わなくても簡単に示せますが...). それを確認してみましょう.

もし,


が成り立つとしましょう (この部分をFKG不等式を使って示します).
すると

となり, 帰納的に
となります. 最後に成り立つと仮定した部分ですが,
とおくと, monotone increasing (言い換えれば$f(G+e)\geq f(G)$ for any $e\in \binom{V}{2}\setminus E(G)$) なので, FKG不等式より

$\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]$.

上式にある$\mathrm{E}(\cdot)$はそれぞれindicatorの期待値なので対応する確率となる (証明終).

限界効用逓減性


上の例では$f,g$を事象のindicatorとしていました. それに倣い, $f,g$をそれぞれ事象$A,B$のindicatorとしましょう. FKG不等式より

$\Pr(A\cap B)=\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]=\Pr(A)\Pr(B)$.

言い換えれば $\Pr(A|B)\geq \Pr(A)$ となります. これを情報量の言葉で書き換えると
$-\log \Pr(A|B) \leq -\log \Pr(A)$ です. つまり「Bの発生を知った上でのA発生の情報量」は「A発生の情報量」より少ないことを意味します. 解釈として, 例えば「食べログで高評価(=Bで条件付けられている)の店Sに入って美味しいものを食べたときの感動(=Aの情報量)」は「なんとなく入った店Sで美味しいものを食べたときの感動」よりも相対的に小さいという感じです.

もちろんこの解釈は$f,g$をindicatorに限った時の話であって, FKG不等式はこれをより一般に単調関数について拡大した不等式である, という見方ができるんじゃないかと思います.


FKG不等式の応用先


- Jansonの不等式の証明
- 本記事で証明したrandom graphのsubgraphの話
- 乱択アルゴリズムの解析 (PPSZ algorithmなど)
など

2018年8月30日木曜日

ランダムグラフの直径の直感的な話

普段はそこそこ真面目な記事を頑張って書いていますが今回はしょうもない話をします. いろんな数学の定理を理解するためにはやはり直感的な理解というのも重要だと思っていて, 今回はランダムグラフの直径についての直感的な理解の助けになるような話を電車で思いついたのでそれを垂れ流そうと思っています. ランダムグラフについては昔の記事にさわりだけ書いてあるので興味のある方はぜひ.

グラフ$G$の直径が $D$ 以下であるということは, どの頂点ペアに対しても長さ$\leq D$のパスが存在するということになります.

今, 各辺が独立に確率$p$で結ばれたランダムグラフ $G(n,p)$ を考えます. このグラフが長さ $l$ のパスを何本持つかを考えてみましょう. 簡単のため $l\in\mathbb{N}$ は定数とします. 期待値的には, 長さ$l$のパスは$l+1$個の頂点と$l$本の辺を持つため, $n(n-1)\cdots (n-l)p^l\approx n(np)^l$だけ含まれています.

ということは長さ$\leq D$のパスは期待値的には全部で $n\sum_{l=1}^D (np)^l \approx n^{D+1}p^D$ だけ含まれています. 冷静に考えると, パスの本数といった「〜の数」というものは指示関数の和によって表すことができます. 今回の場合は$\sum_{P:path}1_{[P\subseteq G(n,p)]}$といった具合です. それぞれの指示関数は独立のいうわけではありませんが, パスが辺素なら独立なので, 「なんとなく独立っぽい感じ」の確率変数の和ということになります. たくさんの独立な確率変数の和は期待値の周りに集中する(c.f. Chernoff bound)ので, $G(n,p)$は長さ$\leq D$のパスを$n^{D+1}p^D$本くらい含んでいそうです. 実際この直感はそこそこ正しくて, Jansonの不等式やこの結果を用いるとChernoffに近い感じの集中性が示せます (ただしどれくらい集中性が強いのかはかなり難しい問題です).

さて, $G(n,p)$の直径が$\leq D$である確率を考えます. 先ほどの直感を信じて長さ$\leq D$のパスが $n^{D+1}p^D$本あるとしましょう. 各頂点ペアにこれらのパスをランダムに「配分」することを考えます. ランダムグラフなのでパスの本数に偏り(例えば頂点1,2間には長さ$D$のパスが114514本あって頂点3,4間には1本もない)みたいなものは起こりにくいはずです。そこで$\binom{n}{2}$個の空のバケツがあってそこに$n^{-1}(np)^D$個のボールを一個ずつランダムに投げ入れたときに, 全部のバケツに少なくとも一個のボールが入っている確率を考えます (このイメージは全ての頂点のペアに長さ$\leq D$のパスが少なくとも一本ある = 直径$\leq D$に対応します). するとクーポンコレクター問題を思い出してもらうと, $n^{D+1}p^D \gg \binom{n}{2}\log \binom{n}{2}\approx n^2\log n$ ならば直径$\leq D$になるような気がします.

まとめると, $n^{D-1}p^D\gg \log n$ならば$G(n,p)$の直径は$D$以下, $n^{D-1}p^D \ll \log n$ならば直径は$D+1$以上となる, ことがなんとなくわかります.


実はこの結果は理論的にも正しいです. また, 「$\gg$」と「$\ll$」の境目に関しては次の結果が知られています.

Thm [p.112, Intruduction to Random Graphsより]
定数$D,c$に対して, $p^Dn^{D-1}=\log (n^2/c)$ を満たすよう$p=p(n)$を定めると, 以下が成り立つ:

  • $\lim_{n\to\infty} \Pr(\mathrm{diam}(G(n,p))=D)=\exp(-c/2)$,
  • $\lim_{n\to\infty} \Pr(\mathrm{diam}(G(n,p))=D+1)=1-\exp(-c/2)$.


証明はこの記事で説明した話とは全く違いますが, それほど難しくはないです. 距離$D$のペアの個数についてPoisson approximation theoremを適用するために頑張って計算するというものです.

2018年7月29日日曜日

Hardness in P (SETH編)

- Introduction


計算複雑性理論では1950年代以降, 「多項式時間で解けるか否か」の解明が一つのテーマとなっています. しかしそもそも多項式時間で解けることが示されている問題はほとんどなく, 実際にはP≠NP予想を仮定して色々示すということがなされています.

P≠NP予想は「論理式の充足可能性(SAT)と呼ばれる問題を解く決定性チューリング機械上で実行される多項式時間アルゴリズムは存在しない」という予想ですが, よく知られる通りこの予想を仮定すると巡回セールスマン問題だとかグラフの最大クリークといった問題が多項式時間で解くことが出来ないということが導出できます.

一方で (P≠NPの下で) 多項式時間で出来ないからといってそこで研究が終わるわけではありません. 例えばグラフの最大独立点集合を求める問題はNP-困難ですが$O(1.2278^n)$ 時間で解くことが出来ますし, ハミルトン閉路の検出は$O(1.63^n)$時間のモンテカルロ乱択アルゴリズムが知られています. つまり「多項式時間で(多分)解けない」から発展し「具体的にはどれくらいの時間で解けるのか」というトピックの研究が近年盛んに行われており, fine-grained complexityなどと呼ばれています. fine-grainedとは「細かな」というような意味合いです.

もちろん, NP-困難な問題に対する
・近似アルゴリズムやその限界. 例えばPCP定理、Unique games conjectureなど.
・特殊なタイプのグラフに対する高速なアルゴリズム. 例えばFPT (fixed parameter tractability)アルゴリズムやW-階層.
といった方向性の研究も盛んです.

また一方で多項式時間で解けるからといってそこでも研究が終わるわけではありません. 多項式時間で解ける問題をより高速に解こうとする方向性の研究もまた盛んに行われています. 最たる例は行列積で, 素朴に計算すると$O(n^3)$時間かかりますが2018年7月現在最速のアルゴリズムは$O(n^{2.3728639})$時間 [François 2014] です (ちなみにそれ以前の最速アルゴリズムは$O(n^{2.3728642})$時間 [Vassilevska Williams 2011] なのでかなり接戦です). 計算モデルによって計算時間が変わってきますが, 本記事では計算モデルとして$O(\log n)$ bit word RAM モデルを考えます.

今回紹介するのは多項式時間で解ける問題(クラスP)における困難性を追求する研究で,「Hardness in P」と言います. たまに「fine-grained complexity」とも言ったりしますが, クラスPの問題を扱うときはHardness in Pと言うような気がします (厳密に言うとクラスPは判定問題のクラスですが「Hardness in P」という名称はその点には少し目を瞑っているような気がしますし特に混乱も起きないと思うので本記事もそれに倣います). 冒頭で述べたように, 時間計算量の下界を示すようなテクニックはほぼ知られていないため, P≠NP予想といった何かしらの予想を仮定してその下で様々な問題の計算量の下界を導出するといった流れをHardness in Pでもとっています.

ではHardness in Pではどのような予想を仮定するのでしょうか. 結論から言うとたくさんあり, 主にAPSP予想, 3SUM予想, SETHの三つが仮定されることが多いのですが(下図), 本記事ではSETHに焦点を絞って紹介していきたいと思います (APSP予想は以前の記事でちらっと触れています).


- SETH (Strong Exponential Time Hypothesis)


SETHは日本語では強指数時間仮説と呼ばれているそうです. HypothesisとついていますがConjectureだと捉えた方が理解しやすいと考えているので「予想」として扱います(なんでHypothesisなのかはよく分かりません. 信じるか信じないかで使い分けているのでしょうかね). 簡単に言うとSETHは「SATは$O((2-\epsilon)^n)$時間で解けない」という予想です. k-SATはそれぞれの節が高々k個のリテラルからなるCNFで記述された論理式の充足可能性を判定する問題です. 変数の個数を$n$、節の個数を$m$で表します。節の組み合わせから, $m\leq O((2n)^k)$が言えます. 2-SATは多項式時間で解けますが3-SATはNP-完全であることが知られており, 素朴に解くと$O(2^n\cdot m)$時間かかります. 実は3-SATは$O(1.308^n)$時間乱択アルゴリズムが知られており[Hertli, 2014], 決定性アルゴリズムに限るとk-SATは$2^{\left(1-\frac{1.44}{k}\right)n}$時間で解けることが知られています [Moser and Scheder, 2011]. つまり$k\to\infty$とするとその計算時間は漸近的に$2^n$となるわけです. これが$1.99^n$に改善できない, がSETHの主張です。

予想 (SETH) [Impagliazzo, Paturi and Zane, 2001]
任意の$\epsilon>0$に対してある$k>0$が存在してk-SATは$O((2-\epsilon)^n)$時間で解けない.

細かい話をするとこれは「アルゴリズムの列」が存在しないと言っています. SETHの否定は「アルゴリズム列$(\mathcal{A}_k)_{k\in\mathbb{N}}$が存在して各$\mathcal{A}_k$はk-SATを$O((2-\epsilon)^n)$時間で解く, というような$\epsilon>0$が存在する」となります. 自分は以前, SETHをパラメタ化計算量の文脈で解釈しようとし「$k$でパラメタライズされたときにk-SATは$f(k)\cdot (2-\epsilon)^n$時間で解くようなアルゴリズムは存在しない」と誤解していたのですが, これはSETHよりも弱い命題(これはSETHから導出できる)です. またこの二つの主張が等価かどうかもわかっていないと認識しています.

SETHを仮定するとOrthogonal Vectors Conjecture (OVC)と呼ばれる予想が導出され, 実はOVCがHardness in Pにおいて起点となる予想として頻繁に用いられます (ですがSETHの方が著名なので論文のタイトルにはOVCではなくSETHが用いられることが多いような気がします).


- Orthogonal Vectors Conjecture


OVCは強いて和訳するなら「直交ベクトル予想」でしょうか. 次の判定問題を考えます.

問題 (Orhogonal Vectors, 直交ベクトル検出問題)
入力:$A,B$: それぞれ$d$次元$01$ベクトルの集合で$|A|=|B|=n$.
出力:ある$a\in A,\,b\in B$が存在して$\sum_{i=1}^d a_ib_i=0$ならばYes. そうでないならばNo.

Orthogonal Vectorsに対応する和訳が (私の知る限り) ないので, 直交ベクトル検出問題と便宜上呼ぶことにします. この問題は素朴に解くと$O(dn^2)$時間かかりますが, 実は$O(n^{2-1/O(\log(d/\log n))})$時間で解くことが出来ます [Abboud, Williams, and Yu 2015]. $d=k\log n$とするとこれは$O(n^{2-1/O(\log(k))})$時間なので, $k\to\infty$とすると漸近的に$O(n^2)$時間となります. これが$O(n^{2-\epsilon})$時間に改善出来ないというのがOrthogonal Vectors Conjecture (OVC)です.

予想 (OVC)
任意の$\epsilon>0$に対してある$k>0$が存在して$d=k\log n$に対する直交ベクトル検出問題は$O(n^{2-\epsilon})$時間で解けない. つまり、$d=\omega(\log n)$ならばOrthogonal Vectorsは$\Omega(n^{2-o(1)})$時間を要する.

繰り返しになりますが, 計算モデルは$O(\log n)$ bit word RAM モデルです. また, SETHの箇所で説明したようにこの予想でも「アルゴリズム列」の存在性を否定しています.

次の定理が知られています.

定理1 [Williams, 2005]
SETHを仮定するとOVCは真. 対偶をとると, 次元$d=k\log n$の直交ベクトル検出問題を$O(n^{2-\epsilon})$時間で解くアルゴリズム列$(\mathcal{A}_k)$が存在するならば, k-SATは$O((2-\epsilon')^n)$時間で解ける ($\epsilon'>0$は$\epsilon$に依存する定数).

定理1は Sparsification lemma+賢い帰着 によって示すことができます。

定理2 (Sparsification lemma) [Impagliazzo, Paturi and Zane, 2001]
$n$変数$m$節を持つk-SATのインスタンス$\phi$が与えられたとき, 以下の条件を満たすような論理式の集合$\phi_1,\ldots,\phi_l$を出力する$O(2^{\epsilon n})$時間アルゴリズムが存在する ($\epsilon>0$は任意の定数).
  1. 各$\phi_i$は$n$変数のk-SATで, 節数は高々$K_\epsilon n$となる ($K_\epsilon$は定数).
  2. $\phi$が充足可能 iff ある$i$が存在して$\phi_i$は充足可能.
  3. $l\leq 2^{\epsilon n}$.

Sparsification lemmaを用いるとSETHを考える上ではk-SATのインスタンス$\phi$の節数$m$は$O(n)$であるとして良いことになります. Spaisification lemmaがどのようにして定理1の証明に用いられるかを説明しましょう.

定理1において, Orthogonal Vectorsが$O(n^{2-\epsilon})$時間で解けたと仮定し, 何らかの$\epsilon'>0$に対しk-SATを$O((2-\epsilon')^n)$時間で解くことを目標としましょう. 適当に$\delta=\delta(\epsilon)>0$を$\epsilon$に依存するものすごく小さい定数と設定します (後で定められます). k-SATのインスタンス$\phi$をSparsification lemmaによって$\phi_1,\ldots,\phi_l$に分解し ($l\leq 2^{\delta n}$), 各$\phi_i$を解くことを考えます. それぞれの$\phi_i$は高々$K_\delta n$個の節を持っています.

図1: 節数$m=O(n)$なるk-SATを直交ベクトル検出問題に帰着している.


ここで$n$個ある変数を半分ずつ二つのグループに分け, それぞれのグループについて$2^{n/2}$通りの(部分)割り当てを列挙します. 列挙された部分割り当て一つ一つが$d=m\leq K_\delta n$次元ベクトル$\in\{0,1\}^m$をなし直交ベクトル検出問題のインススタンスを形成します. 節$i$が部分割り当てによってtrueになるならば, その節に対応する成分が1にします (図1参照). それぞれのグループに対してこの手続きによってベクトルの集合を生成し, それら二つの集合を$A,B$として直交ベクトル検出問題のインスタンスとします. すると, このインスタンスがYesインスタンス(i.e., 直交ベクトルを持つ)であることと論理式$\phi_i$が充足可能であることが同値であることが簡単に分かります. これは各節はリテラルのorによって結合されたものであるため, 節iが充足されていることと対応する二つの部分割当の少なくとも一方が節iを充足する(i.e., ベクトルの第i成分=0)が等価になるからです. さて, $N=|A|=2^{n/2}$とおきます. ベクトルの次元は$m\leq K_\delta n=O(\log N)$となります. 最初の仮定よりこのインスタンスは$O(N^{2-\epsilon})=O(2^{(1-\epsilon/2)n})$時間で解けます. したがって全体の計算量は

$O(2^{\delta n}\cdot 2^{(1-\epsilon/2)n})=2^{(1-\epsilon/2+\delta)n}$

となり, 適切に$\delta>0$を設定してやると所望の結果が示せます. Sparsification lemmaは節の個数が変数の個数$n$に対して線形にできるという部分が強力ですし, SETHがETHを導出するという命題の証明にも使われます. ちなみにSparsification lemmaの証明には組合せ論におけるsunflower lemmaという命題を用いていて、例えばこちらに分かりやすく載っていますが, 個人的には結構面白いと思います.

ここからはOVCの下で様々な問題の計算量下界を見ていきます.

- 直径 2 vs. 3


直径$3$以下であることが約束されたグラフ$G=(V,E)$が与えられたときにその直径が2か3かを判定する問題を考えます. 直径とは最長の最短経路長として定義され, ここでは辺重みは全て1とします. グラフの頂点数を$n$, 辺数を$m$としたときに(OVCの下で)この判定問題が$O(m^{2-\epsilon})$時間で解けないことが知られています [Roditty and Vassilevska Williams, 2013]. 特にこの結果はグラフの直径の$1.499$-近似が$O(m^{1.999})$時間で計算できないことを意味します.

定理3 [Roditty and Vassilevska Williams, 2013]
与えられたグラフの直径が2か3かどうかを$O(m^{2-\epsilon})$時間で判定出来るならば, OVCは偽である.

注意されたいのは, この定理は密なグラフの直径の計算量については何も言っていません. 実際, 以前の記事で紹介したようにどんなグラフでもその直径は$O(n^\omega \log n)=O(n^{2.373})$時間で計算することが出来るからです.
これを証明したいと思います. 直交ベクトル探索のインスタンス$(A,B)$から次の性質を満たすグラフ$G$を構成することを考えます.

性質: $(A,B)$がYesインスタンスであるならば$G$の直径は3, そうでなければ$G$の直径は2.
図2: ベクトル$a\in A,\,b\in B$が直交するならば$a,b$間の最短経路長は3.


図2のようなグラフ$G$を構成します. $G$の頂点集合は$A,B,[d]=\{1,\ldots,d\},u,v$からなり, ベクトル$a$の第$i$成分が1ならば辺$\{a,i\}$を貼り, $B$についても同様に辺を貼ります. $[d]\cup\{u,v\}$の部分は全頂点ペアに辺を貼ってクリークにし, $A$-$u$間と$B$-$v$間も同様に全ペアに辺を貼ります. すると$G$の直径3以上であることと$(A,B)$が直交ベクトルを持つことが同値であることが分かります (直交していなければ, $\{a,i\},\{b,i\}\in E(G)$なるインデックス$i$が存在して距離2になる).

直径2と3の区別が$O(m^{2-\epsilon})$時間で出来るとしましょう. 直交ベクトル検出問題のインスタンス$(A,B)$から上のようにしてグラフ$G$を構成します (これは$O(nd)$時間でできます). このとき$m=O(nd)=O(n\log n)$なので, $O(m^{2-\epsilon})=O(n^{2-\epsilon+o(1)})$時間で直交ベクトル検出問題が解けることになり, これはOVCに矛盾します.

また, 図2のグラフの木幅は$d+2=O(\log n)$であることに注目すると, 次の結果も示されたことになります.

定理4 [Abboud, Vassilevska Williams and Wang, 2016]
木幅$k$のグラフの直径の$1.499$近似を $2^{o(k)}\cdot n^{2-\epsilon}$時間で計算できるならば, OVCは偽.

証明: $2^{o(k)}n^{2-\epsilon}=n^{2-\epsilon+o(1)}$より明らか.

ちなみに木幅$k$のグラフの直径は(辺に重みがあっても)$2^{O(k\log k)}n^{1+o(1)}$時間で計算できることが[Abboud, Vassilevska Williams and Wang, 2016]において知られており, $2^{O(k)}n^{2-\epsilon}$時間で出来るか否かはこの2年間未解決でしたが, 今年解決されました (この論文は2018年8月開催予定のIPECという国際会議に採択されています. arXivを読む限り, 内容は正しそうだと私は思っています).


- その他の問題


直径の他にも様々な問題に対してSETHの下での時間計算量下界が示されています. 例を挙げると
などがあります.

- そもそもSETHは正しいのか?


強い予想を仮定すると色々と面白いことが言えるというのはそもそも当たり前です. そもそも第一にそもそも仮定する予想が本当に正しいのかどうかに関しては議論の余地が大いにあります. 例えば行列積は昔は$O(n^{2.999})$時間で解けないと思われていましたが, 実際は (環上で) $O(n^{2.373})$時間で計算できます. しかしSETHが偽ならば回路計算量で強い下界が成り立つという結果も知られています [Williams, 2013]. もちろん, 仮定している予想が本当に正しいかどうかという問題意識はfine-grained complexityをやっている研究者にもありますし, もっと弱い仮定の下でいろんなことを導出するような論文もあります. 

また, 予想がたくさん出てきている, 悪く言えば乱立しているのも実情です. パッと思い浮かぶだけでも
- SETH
- APSP予想 (APSP: All-Pairs Shortest Paths)
- 3SUM予想
- Gap-ETH
- Clique conjecture (サイズ$k$のクリークが$O(n^{k\omega/3-\epsilon})$時間で検出できないという予想. $\omega<2.373$は行列積の指数)
などがあり, ここ1,2年のSODA論文でもこのような予想の下での困難性の結果に関する論文がたくさん出てきています. しかも, 上に挙げた予想に対し「予想Aを仮定すると予想Bは真である」といった結果は一切知られていません.

そもそも計算複雑性理論においては仮定なしで下界を示すような結果は本当に少なく, average case complexityの分野におけるplanted clique conjecture, 近似アルゴリズムにおけるunique games conjectureといった全く上記とは別の予想の下での困難性の結果がたくさん研究されているので, fine-grained complexityだけの問題点ではなく, 今に始まった議論ではありません. しかしSETHが真だとしても偽だとしても様々な計算量下界が導出されるので, とても面白いと思います.

P vs. NPの現状

最近、ミレニアム未解決問題の一つがAIによって解決されたという情報やその過程が世間を騒がせている。特に今後の数学の在り方について、様々な意見が表明されており、私は毎日興味深く拝聴している。この流れに乗じて、 P vs. NP問題(ひいてはその分野)は現状どのような状況なのか につ...