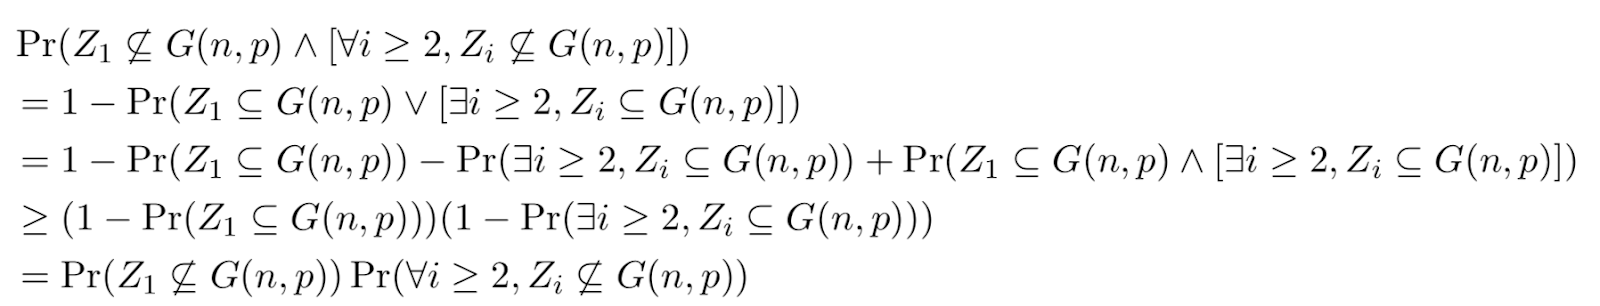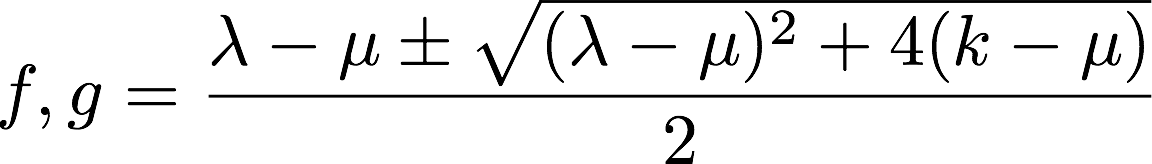2018年9月3日月曜日

FKG不等式とその解釈

FKG不等式という不等式を紹介します.
私自身そこまで詳しくはなく, 考えていたら面白い解釈を思いついたので記事に起こした次第です.
形がシンプルで, よく考えると劣モジュラ性に現れる限界効用逓減性っぽい雰囲気が感じられ, さらに名前がカッコイイので個人的に激アツな不等式です.

準備

・$\{0,1\}^m$上の離散確率を考える (例えばErdős–Rényi model).
・$f,g:\{0,1\}^m \to \mathbb{R}_{\geq 0}$ ... monotone increasing ($\{0,1\}^m$上の順序はbitwiseで比較)
・各$i=1,\ldots,m$に対してbinaryな確率変数$X_i$を定め, $\Pr(X_i=1)=p_i$とする.
・このとき, $f(X_1,\ldots,X_m)$ と $g(X_1,\ldots,X_m)$ は確率変数となる. 

定理 (FKG不等式)


$\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]$.
実は$\{0,1\}^m$は束にまで一般化できる. 


Remark.
・$f,g$がどちらも monotone decreasing でも成り立ちます (両辺に $-f,-g$ を代入).
・要するに共分散 $\mathrm{Cov}[fg]\geq 0$ と言っているだけなので, 両方ともmonotone ならば正の相関がある, みたいな認識です.


例 (Erdős–Rényi modelの部分グラフ)


$f,g$としてindicator functionを考えるのが一番簡単でしょう.
$m=\binom{n}{2}$, $p_i=p\in[0,1]$とすると, この設定はErdős–Rényi model $G(n,p)$と同等になる. その頂点集合を$V=[n]=\{1,\ldots,n\}$と定め, $Z_1,\ldots,Z_k\subseteq E(K_n)$を$V$上の完全グラフ$K_n$の辺部分集合とする.

例えば, 二頂点$s,t\in V$を固定し$Z_1,\ldots,Z_k$を$st$を結ぶ長さ4のパスの全体を考えたりできます. ここで各$Z_i$は頂点にラベルがついていることに注意してください. 従ってこの例だと$k=(n-2)(n-3)(n-4)$となります.

ここで確率
$\Pr(\forall i,Z_i\not\subseteq G(n,p))$
を考えます. FKG不等式を用いると
$\Pr(\forall i,Z_i\not\subseteq G(n,p))\geq \prod_i \Pr(Z_i\not\subseteq G(n,p))$
が簡単に示せます (実は使わなくても簡単に示せますが...). それを確認してみましょう.

もし,


が成り立つとしましょう (この部分をFKG不等式を使って示します).
すると

となり, 帰納的に
となります. 最後に成り立つと仮定した部分ですが,
とおくと, monotone increasing (言い換えれば$f(G+e)\geq f(G)$ for any $e\in \binom{V}{2}\setminus E(G)$) なので, FKG不等式より

$\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]$.

上式にある$\mathrm{E}(\cdot)$はそれぞれindicatorの期待値なので対応する確率となる (証明終).

限界効用逓減性


上の例では$f,g$を事象のindicatorとしていました. それに倣い, $f,g$をそれぞれ事象$A,B$のindicatorとしましょう. FKG不等式より

$\Pr(A\cap B)=\mathrm{E}[fg]\geq \mathrm{E}[f]\mathrm{E}[g]=\Pr(A)\Pr(B)$.

言い換えれば $\Pr(A|B)\geq \Pr(A)$ となります. これを情報量の言葉で書き換えると
$-\log \Pr(A|B) \leq -\log \Pr(A)$ です. つまり「Bの発生を知った上でのA発生の情報量」は「A発生の情報量」より少ないことを意味します. 解釈として, 例えば「食べログで高評価(=Bで条件付けられている)の店Sに入って美味しいものを食べたときの感動(=Aの情報量)」は「なんとなく入った店Sで美味しいものを食べたときの感動」よりも相対的に小さいという感じです.

もちろんこの解釈は$f,g$をindicatorに限った時の話であって, FKG不等式はこれをより一般に単調関数について拡大した不等式である, という見方ができるんじゃないかと思います.


FKG不等式の応用先


- Jansonの不等式の証明
- 本記事で証明したrandom graphのsubgraphの話
- 乱択アルゴリズムの解析 (PPSZ algorithmなど)
など

2018年8月30日木曜日

ランダムグラフの直径の直感的な話

普段はそこそこ真面目な記事を頑張って書いていますが今回はしょうもない話をします. いろんな数学の定理を理解するためにはやはり直感的な理解というのも重要だと思っていて, 今回はランダムグラフの直径についての直感的な理解の助けになるような話を電車で思いついたのでそれを垂れ流そうと思っています. ランダムグラフについては昔の記事にさわりだけ書いてあるので興味のある方はぜひ.

グラフ$G$の直径が $D$ 以下であるということは, どの頂点ペアに対しても長さ$\leq D$のパスが存在するということになります.

今, 各辺が独立に確率$p$で結ばれたランダムグラフ $G(n,p)$ を考えます. このグラフが長さ $l$ のパスを何本持つかを考えてみましょう. 簡単のため $l\in\mathbb{N}$ は定数とします. 期待値的には, 長さ$l$のパスは$l+1$個の頂点と$l$本の辺を持つため, $n(n-1)\cdots (n-l)p^l\approx n(np)^l$だけ含まれています.

ということは長さ$\leq D$のパスは期待値的には全部で $n\sum_{l=1}^D (np)^l \approx n^{D+1}p^D$ だけ含まれています. 冷静に考えると, パスの本数といった「〜の数」というものは指示関数の和によって表すことができます. 今回の場合は$\sum_{P:path}1_{[P\subseteq G(n,p)]}$といった具合です. それぞれの指示関数は独立のいうわけではありませんが, パスが辺素なら独立なので, 「なんとなく独立っぽい感じ」の確率変数の和ということになります. たくさんの独立な確率変数の和は期待値の周りに集中する(c.f. Chernoff bound)ので, $G(n,p)$は長さ$\leq D$のパスを$n^{D+1}p^D$本くらい含んでいそうです. 実際この直感はそこそこ正しくて, Jansonの不等式やこの結果を用いるとChernoffに近い感じの集中性が示せます (ただしどれくらい集中性が強いのかはかなり難しい問題です).

さて, $G(n,p)$の直径が$\leq D$である確率を考えます. 先ほどの直感を信じて長さ$\leq D$のパスが $n^{D+1}p^D$本あるとしましょう. 各頂点ペアにこれらのパスをランダムに「配分」することを考えます. ランダムグラフなのでパスの本数に偏り(例えば頂点1,2間には長さ$D$のパスが114514本あって頂点3,4間には1本もない)みたいなものは起こりにくいはずです。そこで$\binom{n}{2}$個の空のバケツがあってそこに$n^{-1}(np)^D$個のボールを一個ずつランダムに投げ入れたときに, 全部のバケツに少なくとも一個のボールが入っている確率を考えます (このイメージは全ての頂点のペアに長さ$\leq D$のパスが少なくとも一本ある = 直径$\leq D$に対応します). するとクーポンコレクター問題を思い出してもらうと, $n^{D+1}p^D \gg \binom{n}{2}\log \binom{n}{2}\approx n^2\log n$ ならば直径$\leq D$になるような気がします.

まとめると, $n^{D-1}p^D\gg \log n$ならば$G(n,p)$の直径は$D$以下, $n^{D-1}p^D \ll \log n$ならば直径は$D+1$以上となる, ことがなんとなくわかります.


実はこの結果は理論的にも正しいです. また, 「$\gg$」と「$\ll$」の境目に関しては次の結果が知られています.

Thm [p.112, Intruduction to Random Graphsより]
定数$D,c$に対して, $p^Dn^{D-1}=\log (n^2/c)$ を満たすよう$p=p(n)$を定めると, 以下が成り立つ:

  • $\lim_{n\to\infty} \Pr(\mathrm{diam}(G(n,p))=D)=\exp(-c/2)$,
  • $\lim_{n\to\infty} \Pr(\mathrm{diam}(G(n,p))=D+1)=1-\exp(-c/2)$.


証明はこの記事で説明した話とは全く違いますが, それほど難しくはないです. 距離$D$のペアの個数についてPoisson approximation theoremを適用するために頑張って計算するというものです.

2018年7月29日日曜日

Hardness in P (SETH編)

- Introduction


計算複雑性理論では1950年代以降, 「多項式時間で解けるか否か」の解明が一つのテーマとなっています. しかしそもそも多項式時間で解けることが示されている問題はほとんどなく, 実際にはP≠NP予想を仮定して色々示すということがなされています.

P≠NP予想は「論理式の充足可能性(SAT)と呼ばれる問題を解く決定性チューリング機械上で実行される多項式時間アルゴリズムは存在しない」という予想ですが, よく知られる通りこの予想を仮定すると巡回セールスマン問題だとかグラフの最大クリークといった問題が多項式時間で解くことが出来ないということが導出できます.

一方で (P≠NPの下で) 多項式時間で出来ないからといってそこで研究が終わるわけではありません. 例えばグラフの最大独立点集合を求める問題はNP-困難ですが$O(1.2278^n)$ 時間で解くことが出来ますし, ハミルトン閉路の検出は$O(1.63^n)$時間のモンテカルロ乱択アルゴリズムが知られています. つまり「多項式時間で(多分)解けない」から発展し「具体的にはどれくらいの時間で解けるのか」というトピックの研究が近年盛んに行われており, fine-grained complexityなどと呼ばれています. fine-grainedとは「細かな」というような意味合いです.

もちろん, NP-困難な問題に対する
・近似アルゴリズムやその限界. 例えばPCP定理、Unique games conjectureなど.
・特殊なタイプのグラフに対する高速なアルゴリズム. 例えばFPT (fixed parameter tractability)アルゴリズムやW-階層.
といった方向性の研究も盛んです.

また一方で多項式時間で解けるからといってそこでも研究が終わるわけではありません. 多項式時間で解ける問題をより高速に解こうとする方向性の研究もまた盛んに行われています. 最たる例は行列積で, 素朴に計算すると$O(n^3)$時間かかりますが2018年7月現在最速のアルゴリズムは$O(n^{2.3728639})$時間 [François 2014] です (ちなみにそれ以前の最速アルゴリズムは$O(n^{2.3728642})$時間 [Vassilevska Williams 2011] なのでかなり接戦です). 計算モデルによって計算時間が変わってきますが, 本記事では計算モデルとして$O(\log n)$ bit word RAM モデルを考えます.

今回紹介するのは多項式時間で解ける問題(クラスP)における困難性を追求する研究で,「Hardness in P」と言います. たまに「fine-grained complexity」とも言ったりしますが, クラスPの問題を扱うときはHardness in Pと言うような気がします (厳密に言うとクラスPは判定問題のクラスですが「Hardness in P」という名称はその点には少し目を瞑っているような気がしますし特に混乱も起きないと思うので本記事もそれに倣います). 冒頭で述べたように, 時間計算量の下界を示すようなテクニックはほぼ知られていないため, P≠NP予想といった何かしらの予想を仮定してその下で様々な問題の計算量の下界を導出するといった流れをHardness in Pでもとっています.

ではHardness in Pではどのような予想を仮定するのでしょうか. 結論から言うとたくさんあり, 主にAPSP予想, 3SUM予想, SETHの三つが仮定されることが多いのですが(下図), 本記事ではSETHに焦点を絞って紹介していきたいと思います (APSP予想は以前の記事でちらっと触れています).


- SETH (Strong Exponential Time Hypothesis)


SETHは日本語では強指数時間仮説と呼ばれているそうです. HypothesisとついていますがConjectureだと捉えた方が理解しやすいと考えているので「予想」として扱います(なんでHypothesisなのかはよく分かりません. 信じるか信じないかで使い分けているのでしょうかね). 簡単に言うとSETHは「SATは$O((2-\epsilon)^n)$時間で解けない」という予想です. k-SATはそれぞれの節が高々k個のリテラルからなるCNFで記述された論理式の充足可能性を判定する問題です. 変数の個数を$n$、節の個数を$m$で表します。節の組み合わせから, $m\leq O((2n)^k)$が言えます. 2-SATは多項式時間で解けますが3-SATはNP-完全であることが知られており, 素朴に解くと$O(2^n\cdot m)$時間かかります. 実は3-SATは$O(1.308^n)$時間乱択アルゴリズムが知られており[Hertli, 2014], 決定性アルゴリズムに限るとk-SATは$2^{\left(1-\frac{1.44}{k}\right)n}$時間で解けることが知られています [Moser and Scheder, 2011]. つまり$k\to\infty$とするとその計算時間は漸近的に$2^n$となるわけです. これが$1.99^n$に改善できない, がSETHの主張です。

予想 (SETH) [Impagliazzo, Paturi and Zane, 2001]
任意の$\epsilon>0$に対してある$k>0$が存在してk-SATは$O((2-\epsilon)^n)$時間で解けない.

細かい話をするとこれは「アルゴリズムの列」が存在しないと言っています. SETHの否定は「アルゴリズム列$(\mathcal{A}_k)_{k\in\mathbb{N}}$が存在して各$\mathcal{A}_k$はk-SATを$O((2-\epsilon)^n)$時間で解く, というような$\epsilon>0$が存在する」となります. 自分は以前, SETHをパラメタ化計算量の文脈で解釈しようとし「$k$でパラメタライズされたときにk-SATは$f(k)\cdot (2-\epsilon)^n$時間で解くようなアルゴリズムは存在しない」と誤解していたのですが, これはSETHよりも弱い命題(これはSETHから導出できる)です. またこの二つの主張が等価かどうかもわかっていないと認識しています.

SETHを仮定するとOrthogonal Vectors Conjecture (OVC)と呼ばれる予想が導出され, 実はOVCがHardness in Pにおいて起点となる予想として頻繁に用いられます (ですがSETHの方が著名なので論文のタイトルにはOVCではなくSETHが用いられることが多いような気がします).


- Orthogonal Vectors Conjecture


OVCは強いて和訳するなら「直交ベクトル予想」でしょうか. 次の判定問題を考えます.

問題 (Orhogonal Vectors, 直交ベクトル検出問題)
入力:$A,B$: それぞれ$d$次元$01$ベクトルの集合で$|A|=|B|=n$.
出力:ある$a\in A,\,b\in B$が存在して$\sum_{i=1}^d a_ib_i=0$ならばYes. そうでないならばNo.

Orthogonal Vectorsに対応する和訳が (私の知る限り) ないので, 直交ベクトル検出問題と便宜上呼ぶことにします. この問題は素朴に解くと$O(dn^2)$時間かかりますが, 実は$O(n^{2-1/O(\log(d/\log n))})$時間で解くことが出来ます [Abboud, Williams, and Yu 2015]. $d=k\log n$とするとこれは$O(n^{2-1/O(\log(k))})$時間なので, $k\to\infty$とすると漸近的に$O(n^2)$時間となります. これが$O(n^{2-\epsilon})$時間に改善出来ないというのがOrthogonal Vectors Conjecture (OVC)です.

予想 (OVC)
任意の$\epsilon>0$に対してある$k>0$が存在して$d=k\log n$に対する直交ベクトル検出問題は$O(n^{2-\epsilon})$時間で解けない. つまり、$d=\omega(\log n)$ならばOrthogonal Vectorsは$\Omega(n^{2-o(1)})$時間を要する.

繰り返しになりますが, 計算モデルは$O(\log n)$ bit word RAM モデルです. また, SETHの箇所で説明したようにこの予想でも「アルゴリズム列」の存在性を否定しています.

次の定理が知られています.

定理1 [Williams, 2005]
SETHを仮定するとOVCは真. 対偶をとると, 次元$d=k\log n$の直交ベクトル検出問題を$O(n^{2-\epsilon})$時間で解くアルゴリズム列$(\mathcal{A}_k)$が存在するならば, k-SATは$O((2-\epsilon')^n)$時間で解ける ($\epsilon'>0$は$\epsilon$に依存する定数).

定理1は Sparsification lemma+賢い帰着 によって示すことができます。

定理2 (Sparsification lemma) [Impagliazzo, Paturi and Zane, 2001]
$n$変数$m$節を持つk-SATのインスタンス$\phi$が与えられたとき, 以下の条件を満たすような論理式の集合$\phi_1,\ldots,\phi_l$を出力する$O(2^{\epsilon n})$時間アルゴリズムが存在する ($\epsilon>0$は任意の定数).
  1. 各$\phi_i$は$n$変数のk-SATで, 節数は高々$K_\epsilon n$となる ($K_\epsilon$は定数).
  2. $\phi$が充足可能 iff ある$i$が存在して$\phi_i$は充足可能.
  3. $l\leq 2^{\epsilon n}$.

Sparsification lemmaを用いるとSETHを考える上ではk-SATのインスタンス$\phi$の節数$m$は$O(n)$であるとして良いことになります. Spaisification lemmaがどのようにして定理1の証明に用いられるかを説明しましょう.

定理1において, Orthogonal Vectorsが$O(n^{2-\epsilon})$時間で解けたと仮定し, 何らかの$\epsilon'>0$に対しk-SATを$O((2-\epsilon')^n)$時間で解くことを目標としましょう. 適当に$\delta=\delta(\epsilon)>0$を$\epsilon$に依存するものすごく小さい定数と設定します (後で定められます). k-SATのインスタンス$\phi$をSparsification lemmaによって$\phi_1,\ldots,\phi_l$に分解し ($l\leq 2^{\delta n}$), 各$\phi_i$を解くことを考えます. それぞれの$\phi_i$は高々$K_\delta n$個の節を持っています.

図1: 節数$m=O(n)$なるk-SATを直交ベクトル検出問題に帰着している.


ここで$n$個ある変数を半分ずつ二つのグループに分け, それぞれのグループについて$2^{n/2}$通りの(部分)割り当てを列挙します. 列挙された部分割り当て一つ一つが$d=m\leq K_\delta n$次元ベクトル$\in\{0,1\}^m$をなし直交ベクトル検出問題のインススタンスを形成します. 節$i$が部分割り当てによってtrueになるならば, その節に対応する成分が1にします (図1参照). それぞれのグループに対してこの手続きによってベクトルの集合を生成し, それら二つの集合を$A,B$として直交ベクトル検出問題のインスタンスとします. すると, このインスタンスがYesインスタンス(i.e., 直交ベクトルを持つ)であることと論理式$\phi_i$が充足可能であることが同値であることが簡単に分かります. これは各節はリテラルのorによって結合されたものであるため, 節iが充足されていることと対応する二つの部分割当の少なくとも一方が節iを充足する(i.e., ベクトルの第i成分=0)が等価になるからです. さて, $N=|A|=2^{n/2}$とおきます. ベクトルの次元は$m\leq K_\delta n=O(\log N)$となります. 最初の仮定よりこのインスタンスは$O(N^{2-\epsilon})=O(2^{(1-\epsilon/2)n})$時間で解けます. したがって全体の計算量は

$O(2^{\delta n}\cdot 2^{(1-\epsilon/2)n})=2^{(1-\epsilon/2+\delta)n}$

となり, 適切に$\delta>0$を設定してやると所望の結果が示せます. Sparsification lemmaは節の個数が変数の個数$n$に対して線形にできるという部分が強力ですし, SETHがETHを導出するという命題の証明にも使われます. ちなみにSparsification lemmaの証明には組合せ論におけるsunflower lemmaという命題を用いていて、例えばこちらに分かりやすく載っていますが, 個人的には結構面白いと思います.

ここからはOVCの下で様々な問題の計算量下界を見ていきます.

- 直径 2 vs. 3


直径$3$以下であることが約束されたグラフ$G=(V,E)$が与えられたときにその直径が2か3かを判定する問題を考えます. 直径とは最長の最短経路長として定義され, ここでは辺重みは全て1とします. グラフの頂点数を$n$, 辺数を$m$としたときに(OVCの下で)この判定問題が$O(m^{2-\epsilon})$時間で解けないことが知られています [Roditty and Vassilevska Williams, 2013]. 特にこの結果はグラフの直径の$1.499$-近似が$O(m^{1.999})$時間で計算できないことを意味します.

定理3 [Roditty and Vassilevska Williams, 2013]
与えられたグラフの直径が2か3かどうかを$O(m^{2-\epsilon})$時間で判定出来るならば, OVCは偽である.

注意されたいのは, この定理は密なグラフの直径の計算量については何も言っていません. 実際, 以前の記事で紹介したようにどんなグラフでもその直径は$O(n^\omega \log n)=O(n^{2.373})$時間で計算することが出来るからです.
これを証明したいと思います. 直交ベクトル探索のインスタンス$(A,B)$から次の性質を満たすグラフ$G$を構成することを考えます.

性質: $(A,B)$がYesインスタンスであるならば$G$の直径は3, そうでなければ$G$の直径は2.
図2: ベクトル$a\in A,\,b\in B$が直交するならば$a,b$間の最短経路長は3.


図2のようなグラフ$G$を構成します. $G$の頂点集合は$A,B,[d]=\{1,\ldots,d\},u,v$からなり, ベクトル$a$の第$i$成分が1ならば辺$\{a,i\}$を貼り, $B$についても同様に辺を貼ります. $[d]\cup\{u,v\}$の部分は全頂点ペアに辺を貼ってクリークにし, $A$-$u$間と$B$-$v$間も同様に全ペアに辺を貼ります. すると$G$の直径3以上であることと$(A,B)$が直交ベクトルを持つことが同値であることが分かります (直交していなければ, $\{a,i\},\{b,i\}\in E(G)$なるインデックス$i$が存在して距離2になる).

直径2と3の区別が$O(m^{2-\epsilon})$時間で出来るとしましょう. 直交ベクトル検出問題のインスタンス$(A,B)$から上のようにしてグラフ$G$を構成します (これは$O(nd)$時間でできます). このとき$m=O(nd)=O(n\log n)$なので, $O(m^{2-\epsilon})=O(n^{2-\epsilon+o(1)})$時間で直交ベクトル検出問題が解けることになり, これはOVCに矛盾します.

また, 図2のグラフの木幅は$d+2=O(\log n)$であることに注目すると, 次の結果も示されたことになります.

定理4 [Abboud, Vassilevska Williams and Wang, 2016]
木幅$k$のグラフの直径の$1.499$近似を $2^{o(k)}\cdot n^{2-\epsilon}$時間で計算できるならば, OVCは偽.

証明: $2^{o(k)}n^{2-\epsilon}=n^{2-\epsilon+o(1)}$より明らか.

ちなみに木幅$k$のグラフの直径は(辺に重みがあっても)$2^{O(k\log k)}n^{1+o(1)}$時間で計算できることが[Abboud, Vassilevska Williams and Wang, 2016]において知られており, $2^{O(k)}n^{2-\epsilon}$時間で出来るか否かはこの2年間未解決でしたが, 今年解決されました (この論文は2018年8月開催予定のIPECという国際会議に採択されています. arXivを読む限り, 内容は正しそうだと私は思っています).


- その他の問題


直径の他にも様々な問題に対してSETHの下での時間計算量下界が示されています. 例を挙げると
などがあります.

- そもそもSETHは正しいのか?


強い予想を仮定すると色々と面白いことが言えるというのはそもそも当たり前です. そもそも第一にそもそも仮定する予想が本当に正しいのかどうかに関しては議論の余地が大いにあります. 例えば行列積は昔は$O(n^{2.999})$時間で解けないと思われていましたが, 実際は (環上で) $O(n^{2.373})$時間で計算できます. しかしSETHが偽ならば回路計算量で強い下界が成り立つという結果も知られています [Williams, 2013]. もちろん, 仮定している予想が本当に正しいかどうかという問題意識はfine-grained complexityをやっている研究者にもありますし, もっと弱い仮定の下でいろんなことを導出するような論文もあります. 

また, 予想がたくさん出てきている, 悪く言えば乱立しているのも実情です. パッと思い浮かぶだけでも
- SETH
- APSP予想 (APSP: All-Pairs Shortest Paths)
- 3SUM予想
- Gap-ETH
- Clique conjecture (サイズ$k$のクリークが$O(n^{k\omega/3-\epsilon})$時間で検出できないという予想. $\omega<2.373$は行列積の指数)
などがあり, ここ1,2年のSODA論文でもこのような予想の下での困難性の結果に関する論文がたくさん出てきています. しかも, 上に挙げた予想に対し「予想Aを仮定すると予想Bは真である」といった結果は一切知られていません.

そもそも計算複雑性理論においては仮定なしで下界を示すような結果は本当に少なく, average case complexityの分野におけるplanted clique conjecture, 近似アルゴリズムにおけるunique games conjectureといった全く上記とは別の予想の下での困難性の結果がたくさん研究されているので, fine-grained complexityだけの問題点ではなく, 今に始まった議論ではありません. しかしSETHが真だとしても偽だとしても様々な計算量下界が導出されるので, とても面白いと思います.

2017年11月12日日曜日

グラフの Spanner と Erdős Girth Conjecture

1. Introduction


離散アルゴリズム・理論計算機科学の界隈で数年前からホットな話題がいくつかありますが, 今回はそのうちの一つであるSpannerを取り上げたいと思います. Spannerと聞くとなんとなく「spanning tree」などを思い浮かべるかもしれませんが, 雰囲気は似ています. 本記事ではあくまでも初歩的な内容までを取り扱います.

グラフ $G=(V,E)$ の全域部分グラフ $H=(V,F)$ (ただし $F\subseteq E$) が $G$の $(\alpha, \beta)$-spannerであるとは, 任意の頂点ペア $u,v\in V$ に対して $d_H(u,v)\leq \alpha\cdot d_G(u,v)+\beta$ が成り立つことです. ここでグラフ$X$に対して$d_X(u,v)$ は頂点 $u,v$ 間の $X$上における最短経路長(距離)とおいています. 気持ちとしては, 辺をたくさん持つようなグラフから辺を取り除いてスパースにしたい. でも元のグラフの構造(最短経路長)をあまり損ないたくない という動機から産み出された概念であって, 例えば大規模グラフに対してその構造上の特性を失わずに前処理で辺を削ってから何か(例えば直径とか)を計算する, みたいな状況を想定しています. 上述の定義における$\alpha$ をstretch, $\beta$ を additive error などと言ったりします. 今回は stretch に着目します.

最近(2011年〜)の理論計算幾科学系の名だたるトップカンファレンス(SODA, STOC, FOCS)において, $(1,\beta)$-spanner と $(\alpha, 0)$-spanner のそれぞれに関する論文が散見されます. 実際に


  • An Optimal-Time Construction of Sparse Euclidean Spanners with Tiny Diameter , Shay Solomon, Ben-Gurion, (SODA11, best student paper)
  • New Additive Spanners , Shiri Chechik (SODA13, best student paper)
  • Near-Optimal Light Spanners , Shiri Chechik, Christian Wulff-Nilsen (SODA16, best paper)
  • The 4/3 Additive Spanner Exponent is Tight , Amir Abboud, Greg Bodwin (STOC16, best student paper)

はそれぞれ上記のカンファレンス(FOCSでの受賞は未だありません)において受賞しています. これを見るといかにSpannerが注目されているトピックであることが分かると思います. さて, Spanner系の研究で実際になされていることは

  • Spannerの辺数と $\alpha, \beta$とのトレードオフの境界
  • 実際にSpannerを構成するアルゴリズム
がメインのトピックになります. 前者のトピックに関しては, 実際にSpannerを構成するアルゴリズムを提案すれば「ここまで辺を削減できる」という上界を得ることができます. では, 「どのアルゴリズムを用いてもこれ以上辺を削減できない」ことを言うためにはどうすれば良いでしょうか?そこで登場するのがタイトルにある Erdős Girth Conjecture です.

2. Erdős Girth Conjecture


グラフの girth (内周) とは, 最小閉路長のことです. 例えば, 図を見ると分かるように, girth$\geq 4$であることと三角形を持たないことは同値です. Spannerとgirthの関係はどこにあるのでしょうか.


上図では, 内周6のグラフから辺 $uw$ を除去しています. 消去後のグラフでは, $uv$間の距離は1から5に変化します. 内周が6なので, $uv$ としてどの辺を選んでもこうなります. すなわち, 内周 $k$ のグラフを持っているとき, そのグラフに対して $(k-2,0)$-spanner となるような真部分グラフを構成することは不可能です.

一方で, こちらの記事で紹介したように, girth $\geq 5$のグラフは辺数が高々 $O(n^{1.5})$ となります. 実は, 一般に girth $\geq 2k+1$ のグラフは辺数が高々 $O(n^{1+1/k})$ となることが知られています (完全二部グラフを見てわかるように, 二部グラフは$n^2/4$くらいの辺を持ちうるので偶数長の閉路は問題にはなりません. 実際, 任意のグラフに対して最大カットのサイズは|E|/2以上なので, 辺数を半分くらいにすれば二部化することができます).  Erdős Girth Conjecture はこの上界が定数倍をのぞいてタイトであることを述べています.

Conj. Erdős Girth Conjecture     

次の2条件を満たすグラフ $G=(V,E)$ が存在する.

  1. $|E|=\Omega(n^{1+1/k})$ を満たす.
  2. $G$の内周が$2k+1$以上である.

 Erdős Girth Conjecture を仮定するとどうなるでしょうか. この予想を満たすグラフ$G$に対し, その$(2k-1,0)$-Spanner を構成しようとするとすでに$G$の内周が$2k+1$以上なので, 所望のSpanner は $G$ 自身でなければなりません ($G$のどの辺 $uv$ を削除しても上述のように距離が $2k$倍になってしまうからです).

一方で, 実は任意に入力で与えられたグラフ $G$ に対して $(2k-1, 0)$-Spanner でかつ辺数が $O(n^{1+1/k})$ なるものを多項式時間で求めるアルゴリズムが知られています[1]. 辺数をこのアルゴリズムより削減できるようなアルゴリズムが存在したとすると,  Erdős Girth Conjecture のグラフを入力として与えたときに上の議論と矛盾してしまいます. つまりこの知られているアルゴリズムが最適である, と結論づけることができます.


3. 余談


実は辺重み有りグラフでも, 辺数が $O(n^{1+1/k})$ なる $(2k-1, 0)$-Spanner を多項式時間で求めるアルゴリズムが知られています[1].

なお,  Erdős Girth Conjecture は $k=1,2,3,5$ の場合は解決されているようです [2].

今回は additive の方には触れませんでしたが, 興味のある方はぜひ調べてみてください.


[1]: I. Althöfer, G. Das, D. Dobkin, D. Joseph, J. Soares. On sparse spanners of weighted graphs. Networks, 9(1): 81–100, 1993

[2]: R. Wenger. Extremal graphs with no C4’s, C6’s, or C10’s. Journal of Combinatorial Theory, 113–116, 1991.

2017年9月30日土曜日

単著論文がSODAに通りました

The Diameter of Dense Random Regular Graphs
という単著の論文がSODA18に採択されました.

SODAは Symposium on Discrete Algorithms という理論的な国際会議で, コンピュータ科学において「トップカンファレンス」と呼ばれるもので, なかなか通すのが難しいと言われています. 今年のSODA17には通した日本人が1,2人しかいなかったと記憶しています. 今年はバルセロナでの開催でしたが, 来年のSODAはニューオリンズです. 他にもFOCS, STOCなどが有名です.

通した論文の内容はランダム正則グラフの直径についてのものです. ランダム正則グラフは次数が定数の場合は直径が漸近的(頂点数→無限)に"最適" (i.e. Moore Boundから得られる直径の理論下界との比が1に収束)で, HPCのネットワークトポロジーとしても有用であることが知られています. しかし次数が頂点数とともに増加する場合はその直径がどうなるかはexplicitには知られていませんでした. (実際にはMoore Bound と最近発表された定理を拾ってくるとだいたいのケースでは上界と下界が得られます). 今回の論文はそのようなランダム正則グラフの直径について, 次数dが $d=\beta \cdot n^{\alpha}$ ($n$は頂点数) の場合だとその直径が $\lfloor \alpha^{-1} \rfloor + 1$ となることを証明しました (研究の本質的な点は, 上記の次数を持つランダム正則グラフに対してMoore Boundから得られる下界と上述の定理から得られる上界の間のギャップに関する問題を解決したという点にあります)

2017年8月24日木曜日

三角形・四角形を含まないグラフ(極値グラフ理論)

0. 概要


グラフ理論の中に「極値グラフ理論 (extremal graph theory)」と呼ばれる分野があります. 極値グラフ理論では, 「与えられた性質$\mathcal{P}$を満たすグラフのうち, 最大辺数を求める」ことを考えます. 極値グラフ理論で最も有名な結果はおそらくTuranの定理でしょう. これは, 性質$\mathcal{P}$を「サイズ$r$の完全グラフ$K_r$を含まない」としたとき, 辺数が最大のグラフは$r-1$部完全グラフであるという結果です.

気持ちとしては, 「どれほどの辺数を持てばグラフが性質$\mathcal{P}$を満たすことを保証できるか」という問題について考えるのが極値グラフ理論です.


1. Triangle-free グラフ


「三角形($=K_3$)を含まない」という性質を満たすグラフのうち最大辺数を持つグラフを考えます. (このようなグラフをtriangle-freeグラフといいます). こちらのページで紹介されているように(またはTuranの定理の帰結として), 完全二部グラフを考えると, 三角形を含まないような頂点数$n$のグラフが持ちうる辺数はおおよそ, 高々$\frac{n^2}{4}=O(n^2)$となります.

2. Triangle & Square-free グラフ


では, 「三角形・四角形を含まない」という性質を満たすグラフの最大辺数について考えます. 結論から言うとこのような性質を持つ頂点数$n$のグラフの辺数は高々$O(n^{1.5})$となることが示せます. 「奇数長の閉路を含まない」という制約を考えても完全二部グラフがとれるので, 辺数が$O(n^2)$になります. しかし四角形の制約を付け加えるだけでオーダーが劇的に下がる, という点が面白い点です. この結果はとても簡単に証明できるので, 紹介します.

定理. 三角形及び四角形を含まない$n$頂点のグラフ$G$の辺数は高々 $\frac{n\sqrt{n-1}}{2}$ である.

証明.
$G=(V,E)$を三角形・四角形を含まない$n$頂点のグラフとします. このグラフが含む長さ2のパスの本数を二通りの方法で数えます:


図のように, 頂点$v$を一つ選んだときに$v$を真ん中の頂点として持つような長さ2のパスを考えます. そのようなパスの個数は$v$に対して$i,j$の選び方の総数に等しいので, $\binom{d_v}{2}=\frac{d_v(d_v-1)}{2}$となります. ここで$d_v$は頂点$v$の次数です.
従って, 長さ2のパスの総数は


となります.


一方, $G$が四角形を含まないため, 隣接していない二頂点$i,j$を選択したときに, $i,j$を端点として持つような長さ2のパスは高々1本となります (下図). 従って, 長さ2のパスの本数は非隣接的な二頂点の選び方の総数, 即ち$\binom{n}{2}-|E|$で上から抑えることが出来ます.

非隣接頂点対$i,j$に対して, $i$と$j$の両方と隣接している頂点は高々一つである.


従って


よって,

                    ...(1)

となります.


次にコーシーシュワルツの不等式を用います. コーシーシュワルツの不等式は

$\left(\sum_v x_v y_v\right)^2 \leq \left(\sum_v x_v^2\right)\left(\sum_v y_v^2\right)$

ですが, これに$x_v=d_v$, $y_v=1$を代入すると

$4|E|^2 = \left(\sum_v d_v\right)^2 \leq n\sum_v d_v^2$                    ...(2)


(1)(2)より,

$\frac{4|E|^2}{n}\leq \sum_v d_v^2 \leq n(n-1)$

従って,

$|E| \leq \frac{\sqrt{n^3-n}}{2} = \frac{n\sqrt{n-1}}{2}$. (証明終)


3. 不等式はタイトなのか?


結論から言うとタイトです. こちらの記事で紹介したMoore graphを考えます. Moore graph は頂点数$k^2+1$の$k$-正則グラフで, かつ三角形・四角形を含まない($\iff$ 直径$=2$)ものです. Moore graph は $k=2,3,7$に対しては存在しますが, これら三つのグラフは辺数が$\frac{kn}{2}=\frac{k^3+k}{2}$となりますが, この値は辺数の上界$\frac{n\sqrt{n-1}}{2}=\frac{(k^2+1)k}{2}$となり, 辺数と等しくなっています.


強正則グラフのスペクトル解析と未解決問題への応用

0. 背景


グラフ理論とは文字通り, グラフについて解析する分野です. グラフ理論のモチベーションとしては, 「最小全域木」「最大マッチング」「最大フロー」などのアルゴリズムを考える際に対象となるオブジェクト(この例で言えば全域木, マッチング, フロー)に対する「良い」特徴付けや性質(例えばHallの結婚定理, グラフマトロイドの基, 交互増加道, 残余ネットワークに関するものなど)を与えるという, アルゴリズム上のモチベーションが最も大きいんじゃないかと思います.

しかしそれとは別に純粋数学寄りな一面もあります. グラフ理論の一分野に「Algebraic graph theory」というのがあります. 直訳すると「代数的グラフ理論」で, この分野はグラフの特徴を代数的に解析するもしくは代数的に「綺麗な」グラフを構成したり, Tutte多項式といった興味深い不変量について解析しています. ここで言う「代数」とは線形代数(スペクトラムグラフ理論)や群(Cayley graph)などです. 面白いことに正則グラフ(全ての頂点の次数がある定数に等しいグラフ)に対するゼータ関数としてIhara zeta function というものが知られていて, Ihara zeta function を用いてラマヌジャングラフと呼ばれるスペクトラムグラフ理論において非常に重要なグラフの特徴づけを与えられています.

グラフの持つ美しい性質の解析の一方で, こちらの記事で紹介したような「小直径グラフを構成する」や「彩色数と内周(girth)が共に大きいグラフ」といった, 普通のグラフでは満たされないような性質を満たすグラフをalgebraic graph theoryの道具を用いて巧妙に構成するという研究も有ります.

今回の記事では 強正則グラフ (strongly regular graph) と呼ばれるグラフについて, スペクトラムグラフ理論においてしばしば用いられるテクニック(=線形代数)を用いて解析していきます. 更にその応用として, グラフ理論における二つの未解決問題(Moore graph と Conway 99 problem)について考察してみます. あらかじめ記しておきますが, 本記事は予想以上に線形代数成分が強いです (というかグラフ理論成分は少なめです).


1. 強正則グラフ


グラフ$G$に対し, その頂点$v$に隣接する頂点の全体を$N(v)$で表します.
$n$頂点の$k$-正則グラフ$G$ (全ての頂点の次数が$k$に等しいグラフ) が以下の全ての性質を満たすとき, $G$はパラメータ$(n,k,\lambda,\mu)$を持つ強正則グラフであると言います.


  1. 任意の隣接する二頂点$u,v$に対して, $|N(u)\cap N(v)|$がある定数$\lambda$に等しい.
  2. 任意の隣接しない二頂点$u,v$に対して, $|N(u)\cap N(v)|$がある定数$\mu$に等しい.

イメージとしてはこんな感じです:


特に, $\mu>0$の場合はグラフの直径は$2$以下となります. $\mu=0$の場合はグラフは非連結で, 各連結成分はサイズ$\lambda+2$の完全グラフになっていて次数は$k=\lambda-1$となります.

例:


・長さ5の閉路 : $(n,k,\lambda,\mu)=(5,2,0,1)$.
・Petersen graph : $(n,k,\lambda,\mu)=(10,3,0,1)$.

Petersen graph


・$n$頂点の完全グラフ : $(n,k,\lambda,\mu)=(n,n-1,n-2,0)$.
・長さ$3$の閉路 : $(n,k,\lambda,\mu)=(3,2,1,0)$.

$\lambda$は三角形の個数, $\mu$は四角形の個数を規定している感じになっています.


2. 強正則グラフのスペクトル


$G$を$(n,k,\lambda,\mu)$をパラメータに持つ強正則グラフとします. 更に$\mu\neq 0$を仮定します. $G$の隣接行列を$A$とします. すなわち


と定めます. 今回の目的は$A$の全ての固有値を特定することです. 固有値を求めてそこから得られる様々な条件を考えることによって, 与えられたパラメータ$(n,k,\lambda,\mu)$に対応する強正則グラフの存在性について議論することが出来ます (後述).

$i\neq j$に対し, $(A^2)_{ij}$は頂点$i$から頂点$j$への長さ2のパスの本数に等しいはずです. $ij$が隣接しているときはこの値は$\lambda$と等しく, そうでないときは$\mu$に等しくなります (上図参照). $i=j$に対しては$A^2_{ij}$は次数に等しいので$k$となります. 以上より


なので, 

$A^2+(\mu-\lambda)A=(k-\mu)I+\mu J$                    ...(1)

となります. ここで $I$ は$n\times n$の単位行列, $J$は全ての要素が1に等しい$n\times n$行列です. 即ち強正則グラフの隣接行列は行列の二次方程式が成り立ちます.

$A$は$k$-正則グラフなので, 各行に含まれる$1$の個数(=次数)は全て$k$に等しいはずです. すなわち $A\mathbb{j}=k\mathbb{j}$ が成り立ちます. ここで$\mathbb{j}\in\mathbb{R}^n$は全要素が$1$の列ベクトルです. 更に$A$対称行列なので全ての固有値は実数であり, しかも最大固有値は$k$に等しく, ($\mu>0$よりグラフは連結なので, $A$は行列として既約であるため, ペロン=フロベニウスの定理より)最大固有値の多重度は$1$となります. したがって$A$の他の固有値$\theta$に対応する固有ベクトル$x$は必ず$\mathbb{j}$と直交します. このベクトル$x$を二次方程式の両辺に掛けると, ($Jx=\mathbb{j}\mathbb{j}^{T}=0$に留意して)

$(A^2+(\mu-\lambda)A)x = (\theta^2+(\mu-\lambda)\theta)x = (k-\mu)x$

となります. したがって$\theta$は以下の二次方程式:

$\theta^2+(\mu-\lambda)\theta-(k-\mu)=0$

の解になっているので, 


以上より, $A$の固有値は三種類しかなく, それらは


となることが分かりました. 更に, $A$に関する二次方程式の両辺に$\mathbb{j}$を掛けると

$k^2+(\mu-\lambda)k=k-\mu+\mu n$                    ...(2)

即ち, $k(k-\lambda-1)=(n-k-1)\mu$ が成り立ちます.

最後に, それぞれの多重度を求めてみましょう. 


とおいてそれぞれの多重度を$s,t$とおきます. すると$A$のトレース(=対角成分の和=固有値の和)は$0$に等しく, 固有値$k$の多重度は$1$であることも合わせると

$fs+gt+k=0$, $s+t=n-1$

となり, これを連立させると


                    ...(3)

が成り立ちます. 即ち $(n,k,\lambda,\mu)$をパラメータとして持つような強正則グラフが存在するためには, これら四つの値が (2)を満たしかつ(3)で与えられる$s,t$が整数とならなければいけません. これらの条件を使うことによって与えられたパラメータに対応する強連結グラフの存在性について議論することが出来ます.

先ほどみたように, 連結な強正則グラフの固有値は3種類しかありません. 面白いことに逆も成り立つことが知られています:

定理1:
$G$を連結な$k$-正則グラフで完全グラフでないものとする. $G$の隣接行列が三つの相異なる固有値$k>s>t$を持つとする. このとき, $G$は強正則グラフである.

また一般に, 固有値の種類数はグラフ(強正則でなくても良い)の直径を上から抑えるということが知られています:

定理2:
連結な$G$に対してその隣接行列が持つ相異なる固有値の個数を$m$とする. $G$の直径は$m-1$以下である.

強正則グラフは固有値は3種類しかないので直径2となっていますが, このことは定理2と整合性がとれています (余談ですが, 定理2の証明は2016年に東京大学情報理工学系研究科の数理情報学専攻の修士課程の大学院入学試験で出題されました).


応用1: Moore graph の存在性


Moore graph とは簡単に言うと「直径$D$の$d$-正則グラフの中で最も頂点を多く含んでいるグラフ」のことです. 詳しくはこちらの記事に書いてあります. Moore graphは

  1. 直径$>2$の場合は存在しない
  2. 直径$=2$かつ$d\not \in \{2,3,7,57\}$ の場合は存在しない.
ことが示されています. 今回は二つ目の事実をこれまでの議論を使って示していきます. こちらの記事より, 直径2のグラフ$G$が Moore graph であることの必要十分条件は, $G$が三角形と四角形を含まないことです. 更に, 明らかに$n=k^2+1$となります). 従って, $G$はパラメータ$(n,k,\lambda,\mu)=(k^2+1,k,0,1)$を持つ強正則グラフとなっていることに注意します($n=k^2+1$は今回導出した(2)の条件に$\lambda=0,\mu=1$を代入することで導出できます).

(3)の整数性条件を考えます. パラメータを代入して計算すると


即ち, $k^2-2k=0$ もしくは $4k-3=p^2$ ($p\in\mathbb{N}$) が必要条件となります. $k^2-2k=0$, 即ち$k=2$に対しては長さ$5$の閉路が対応しています. 2番目の条件より, $k=(p^2+3)/4$ を $s$ に代入すると,

$s=\frac{p^4+6p^2+9}{32}+\frac{p^4-2p^2-15}{32p} = \frac{p^5+p^4+6p^3-2p^2+9p-15}{32p}$

整理すると

$p^5+p^4+6p^3-2p^2+(9-32s)p=15$

従って$p$は$15$を割り切るので, $p\in \{1,3,5,15\}$となり, それぞれの$p$を$4k-3=p^2$に代入ことにより, $k=1,3,7,57$ が得られます. $k=1$の時は$n=k^2+1=2$より, グラフは$K_2$となります (直径2ではないのでこれは除外します).

従って, 直径2のMoore graphが存在するならば, $k\in \{2,3,7,57\}$ が成り立ちます.


応用2: Conway 99 graph problem


元ネタ : https://oeis.org/A248380/a248380.pdf
関連文献 : https://arxiv.org/abs/1707.08047

こちらの問題はグラフ理論というよりは, Conwayが出した未解決な問題であり, 解けたら1000ドルもらえるというプチミレニアム未解決問題です. 具体的には次のような問題です:

問題: 以下の二つの性質を満たす$99$頂点のグラフは存在するか否か.
  1. 任意の隣接している二頂点$u,v$に対して, $u,v$を含む三角形が唯一存在する.
  2. 任意の隣接していない二頂点$u,v$に対して, $u,v$を対角線上に含むような四角形が唯一存在する.
イメージとしては次のような感じです:

三角形は被ってはいけない. 四角形は二辺を共有してはいけない.

本記事では条件1を三角形条件, 条件2を四角形条件と呼ぶことにします (番号が乱立して可読性が下がるため)

問題を見た感じだと正則グラフには見えないのですが, もし所望のグラフ$G$が存在するとして, それが$k$-正則であったならば, $G$はパラメータ$(99,k,1,1)$を持つ強正則グラフであることが分かります. すると(2)の条件より, $k=14$が出てきます. そもそもなぜ頂点数が99なのでしょうか?この記事ではより一般に, パラメータ$(n,k,1,1)$を持つ強正則グラフについて考え, どのような$n$と$k$に対してそのグラフが存在するのかについて考えていきます.  まず明らかですが, $n=3,k=2$に対しては$K_3$が所望の性質を満たすことが確認できます(非隣接点が存在しないため). これ以外に所望のグラフはあるのでしょうか?

実は, 所望のグラフが存在するとしたら, そのグラフは必ず正則であることが次のようにして証明できます:

$G=(V,E)$の頂点数を$n$とします. $G$において隣接している二頂点$u,v$を任意にとってきます. するとある頂点$w\in V\backslash \{u,v\}$が一意に存在して$uvw$が三角形となります. 更に$n\geq 4$のとき, $G$の直径は$2$であり, $k\geq 3$となる ($k=2$ならば$n=3$となってしまうから). 従って$u$に隣接する頂点$z\in V\backslash \{v,w\}$が存在し, この$z$はどれも$v$には隣接していない (そうでないならば, $uvz$が三角形条件に反する. 下図1参照).

図1 : $z$と$v$は隣接してはいけない.

 そこで$z, v$に対して四角形条件を適用すると, $zv$を対角線として持つような四角形$uvz'z$が存在することになります. 特にこの四角形は一意なので, $z$に対して$z'$は唯一定まります (図2). 特に$z'\in N(v)$に注意します.

図2. $vz$を対角線に持つような四角形がとれる. 一方で$z$に対して複数の$z'$をとることは出来ない.

そこで写像$z\mapsto z'\in N(v)$を考えると, これは単射になっています. $z_1\neq z_2 \in N(u)$に対して$z_1\mapsto z'$, $z_2\mapsto z'$となると四角形条件に反するからです.

図3: $z_1,z_2 \mapsto z'$となると$uz'$を対角線に持つ四角形が二つできてしまう.

従って, 単射$N(u)\to N(v)$が構成できた(実際は全単射になっている)ので, $|N(u)|\leq |N(v)|$. 同様にして逆も言えるので, $|N(u)|=|N(v)|$. $G$は連結なので, どの頂点の次数もある定数に等しい. よって$G$は正則である.
以上より, 議論すべきグラフは正則なので, パラメータ$(n,k,1,1)$を持つ強正則グラフです. 更に(2)の条件より, $n=\frac{k^2}{2}+1$となります. $n$の整数性から$k$が偶数であることも直ちに従います. さらに, 固有値の多重度の整数性条件から


すなわち$k^2-4k=0$, $4k-7=p^2$となります.

$k^2-4k=k(k-4)=0$の場合は$k=4$となり, 対応する$n$は$n=\frac{k^2}{2}+1=9$.

$4k-7=p^2$の場合は$k=(p^2+7)/4$を$s$に代入することにより


従って, $p^5+p^4+14p^3-2p^2+(49-64s)p=63$ となるので, $p$は$63$を割り切ります. 即ち$p\in \{1,3,7,9,21,63\}$. 対応する次数$k$は$k\in\{2,4,14,22,112,994\}$.

まとめると, $(n,k,1,1)$をパラメータとして持つ強正則グラフが存在するための十分条件は(計算ミスがなければ)


実際, $(n,k)=(3,2)$に対しては$C_3$が対応しています. しかし$(n,k)=(9,4)$に対しては存在しないことが示せます(三角形条件と四角形条件を使って局所的な構造を絞ることによって示せますがあまり証明としては綺麗ではありません). こちらにあるように, $(n,k)=(9,4)$は具体的にグラフが構成でき, 隣の研究室の後輩に教えられたのですが, $K_{3,3}$の線グラフ(辺と頂点を交換したグラフ)が条件を満たしています. (2018年7月24日追記) $(n,k)=(99,4)$はConwayの99問題に対応しています. 他にも三つほどヤバそうな$(n,k)$がありますが, とりあえず有限個であることは以上の議論より示すことが出来ました.

要するに「99」という数字の本質は線形代数的な議論によって導かれます. また, Moore graphにおいても「次数57」の条件は同様な議論から導出できます. 即ち「良い性質を持った」グラフの存在性については未だに線形代数的な議論によってしか条件を絞り込むことが出来ていないというのが現状です. 従って今回提示した二つの未解決問題を解くためには, 線形代数から少し離れたアプローチ, もしくはよりグラフ理論っぽいアプローチから新たな必要条件を導出するしかないんじゃないかなぁとなんとなく思っています.


3. まとめ


今回の記事では「スペクトラムグラフ理論」と言いながらほとんど「スペクトラムグラフ」感が感じられないものだったので, あまりその凄さが通じなかったのかもしれません. しかし実はスペクトラムグラフ理論の技法はグラフの構造上の特徴の情報を得ることが出来ます. 例えば, $(n,k,1,1)=(99,14,1,1)$をパラメータに持つ強正則グラフ(Conwayの問題におけるグラフ)が存在するならば, その最大独立点集合のサイズが高々22であり, 彩色数は5以上である, ということを証明することが出来ます (驚くべき証明があるのですが余白がないので省略します).

そして実際に今回示した手法によってMoore graph や Conway problem に対してある程度までの必要条件を導出することが出来ました. なお今回のConway problemに関する結果については僕は論文でも見たことはなく, (載っている論文がぱっと見見つからないという意味で)新しいものなのかもしれませんが, 教科書に載っている程度の初等的な議論によって得られる結果なので「プロ」の研究者にとっては既知の情報かとは思います. また, 今回の議論は次を参考文献として提示します.


  • "Elementary Number Theory, Group Theory and Ramanujan Graphs", Giuliana Davidoff, Mount Holyoke College, Massachusetts Peter Sarnak, (2003)
こちらの本はグラフスペクトル理論の初歩的な部分について解説していて, Ramanujan graph についての話題が書いてあります. 前提知識もあまり必要でなく, 非常に読みやすかったです.


  • "Topics in Graph Automorphisms and Reconstruction", Josef Lauri, University of Malta Raffaele Scapellato, Politecnico di Milano, (2016)
こちらの本は algebraic graph theory に関わる話題として automorphism (vertex-transitivityなど)や, グラフ理論における非常に有名な未解決問題: reconstruction conjecture について紹介しています. strongly regular graph, Moore graphについて節が割かれています.

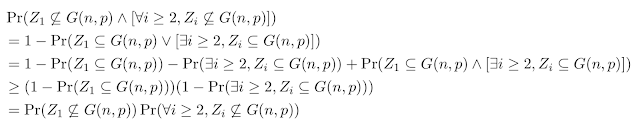
P vs. NPの現状

最近、ミレニアム未解決問題の一つがAIによって解決されたという情報やその過程が世間を騒がせている。特に今後の数学の在り方について、様々な意見が表明されており、私は毎日興味深く拝聴している。この流れに乗じて、 P vs. NP問題(ひいてはその分野)は現状どのような状況なのか につ...